Query fan-out : combien de recherches ChatGPT lance pour répondre à vos acheteurs
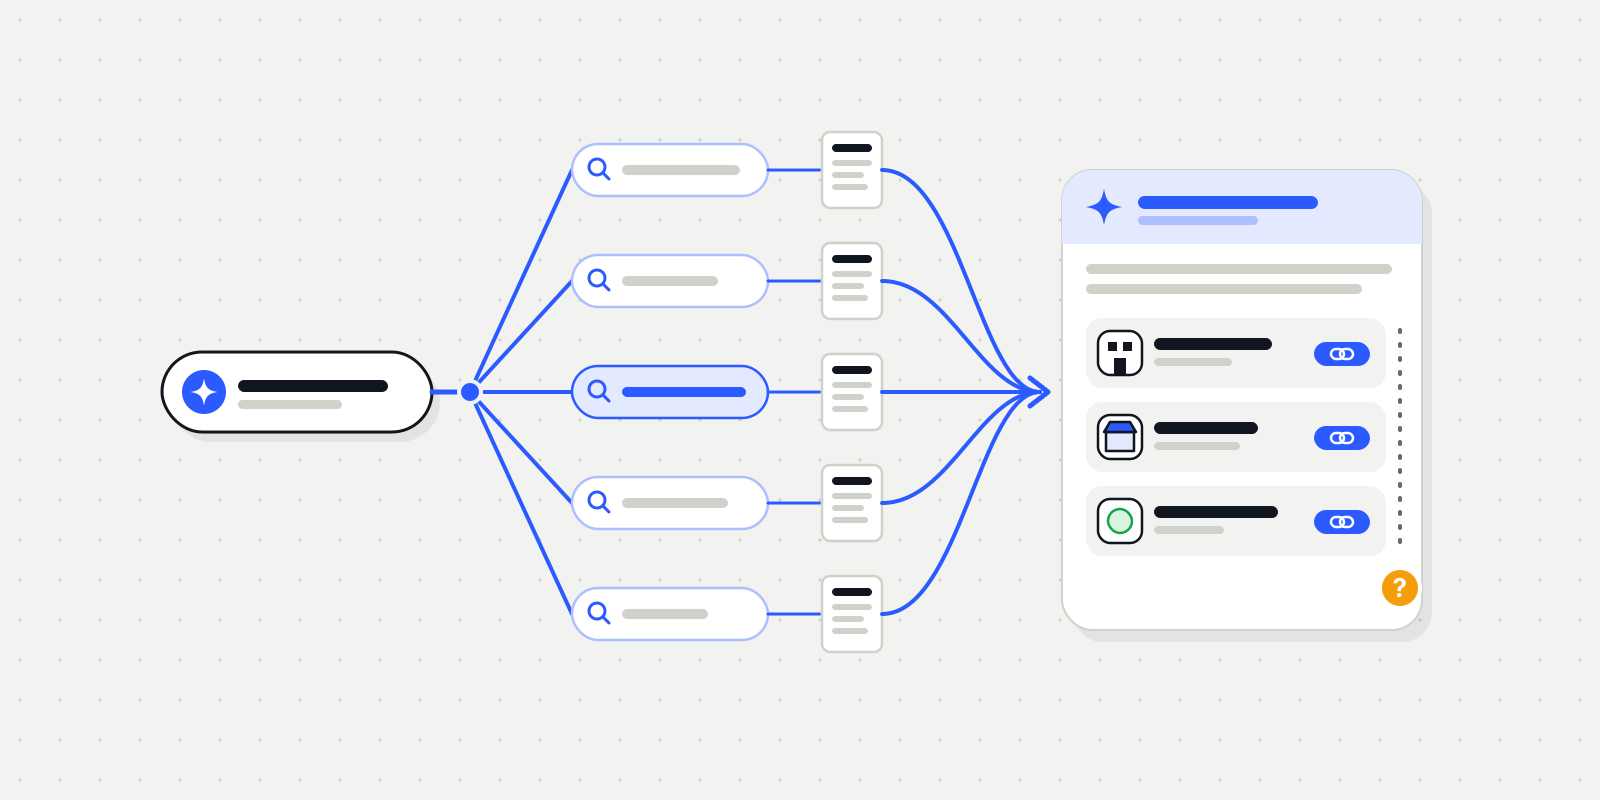
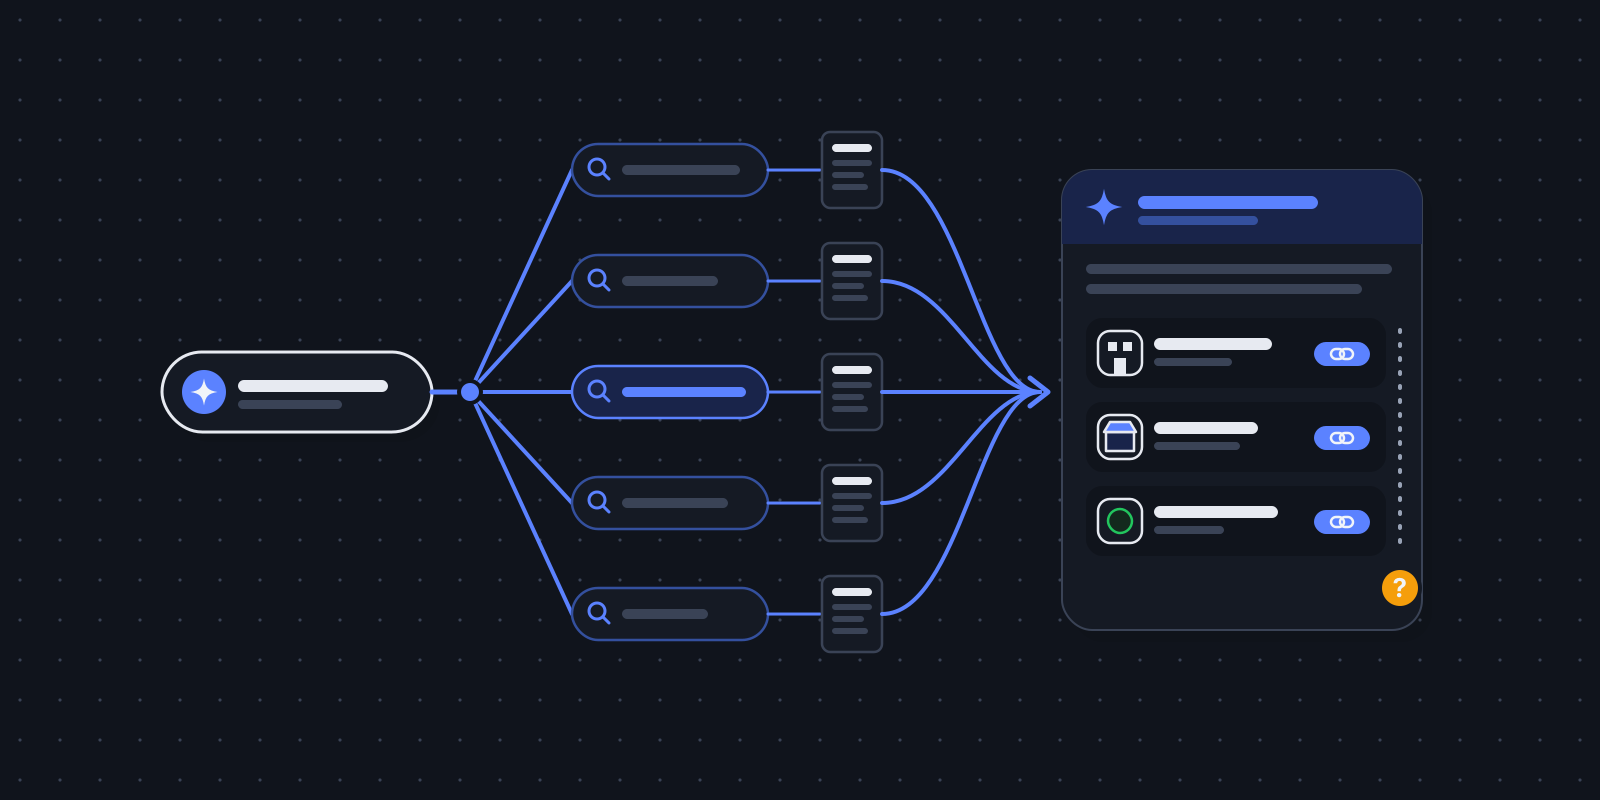
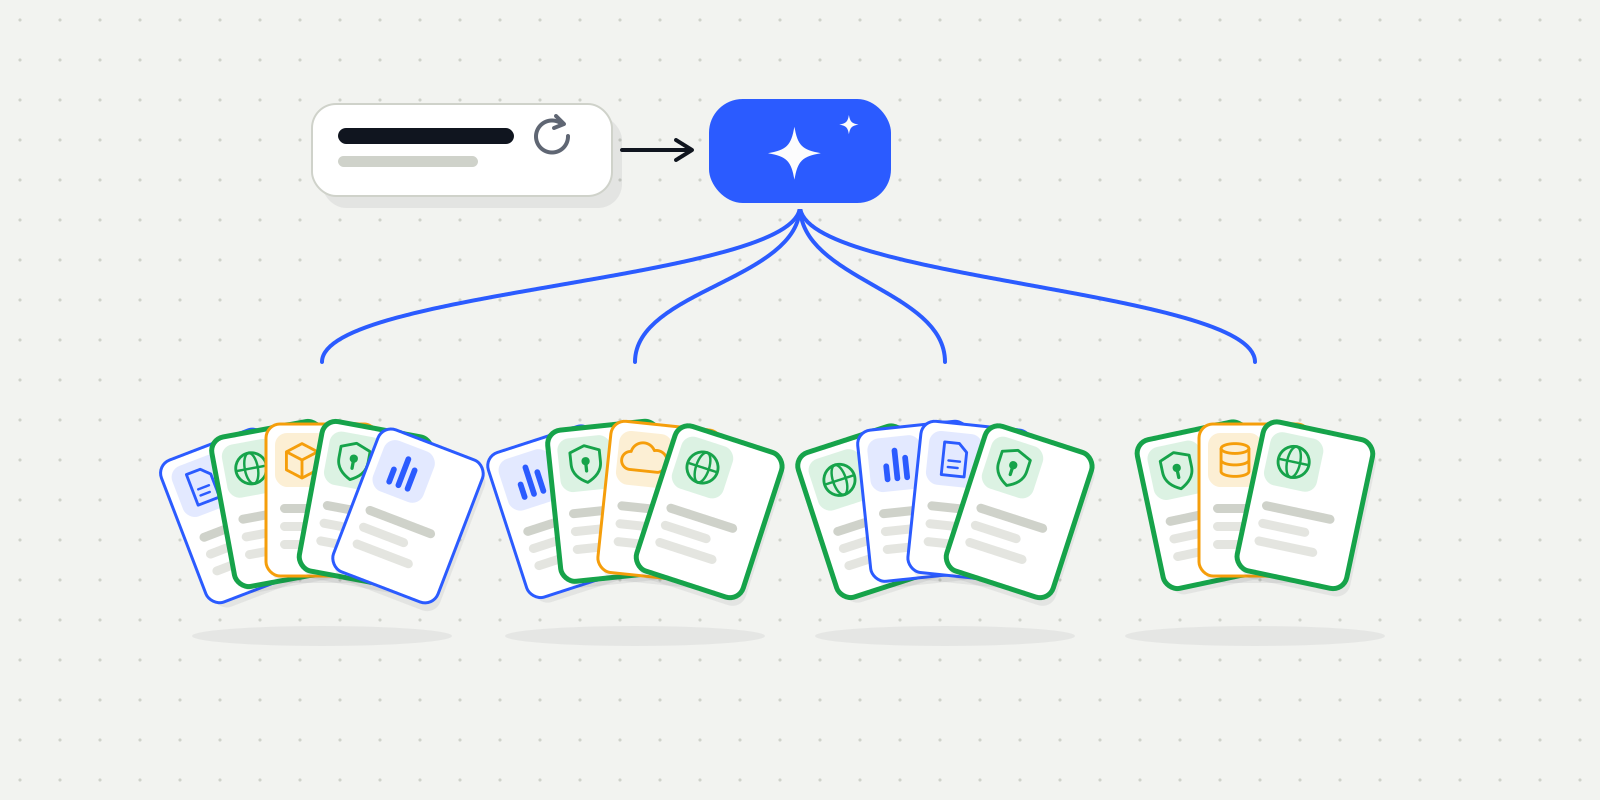
Le query fan-out est le découpage d'une question en plusieurs recherches, lancées par le moteur pour rassembler de quoi répondre. Google le documente pour ses Aperçus IA et son mode IA. Dans les 800 réponses de ChatGPT du corpus principal de l'AI Sources Index d'Evocia (API avec recherche web, 14 septembre 2026), le nombre d'appels de recherche suit surtout le type de question : 0,24 en moyenne pour un problème, 1,56 à 1,73 pour une comparaison, une décision ou une recommandation.
La conséquence pour vos pages est simple. Ce sont vos pages de comparaison et de décision qui sont lues pendant ces recherches : elles doivent répondre à des sous-questions précises, dans des sections qui tiennent seules. Créer une page par variante de requête, en revanche, relève de ce que Google classe comme abus de contenu à grande échelle.
Ce guide, pour qui travaille le GEO, qu'on appelle aussi AEO (optimisation pour les moteurs de réponse), sépare ce qui est documenté, ce qu'Evocia a mesuré et ce que publient les éditeurs d'outils.
L'essentiel en 60 secondes
- Google documente le query fan-out pour ses Aperçus IA et son mode IA ; OpenAI documente que ChatGPT décide lui-même de chercher.
- Sur 800 réponses de ChatGPT (Evocia, 14 septembre 2026) : 0,24 appel de recherche en moyenne pour un problème, 1,73 pour une recommandation.
- Deux recherches ou plus : jamais pour un problème, 70 % des recommandations, 48,1 % des comparaisons.
- Les chiffres de Peec, Seer et Surfer portent sur d'autres moteurs, modèles ou dates : ils ne s'additionnent pas aux nôtres.
- Une sous-question appelle une section, une page si elle a sa propre intention, ou rien si c'est une variante de formulation.
- Les sous-requêtes ne se voient que par l'API : mesurez plutôt les réponses sur les questions de vos acheteurs.
Ce que Google et OpenAI documentent
En bref
Google écrit que les Aperçus IA et le mode IA peuvent utiliser une technique de « query fan-out » : plusieurs recherches liées, sur des sous-thèmes et des sources de données, pour construire une réponse. OpenAI ne parle pas de fan-out : sa documentation dit que le modèle choisit de chercher ou non selon la question, sans plafond publié du nombre de recherches.
Google Search Central, page « AI features and your website » (relue le 17 novembre 2026) : les Aperçus IA et le mode IA « may use a 'query fan-out' technique », c'est-à-dire lancer plusieurs recherches liées sur des sous-thèmes et des sources de données. Les deux surfaces peuvent utiliser des modèles et des techniques différents.
Google, annonce du 20 mai 2025 : le mode IA décompose la question en sous-thèmes et lance « a multitude of queries simultaneously ». Le mécanisme côté Google est détaillé dans comment Google AI Mode choisit les entreprises qu'il recommande.
OpenAI, guide de l'outil de recherche web de l'API (relu le 17 novembre 2026) : « the model can choose to search the web or not based on the content of the input prompt ». Chaque appel de recherche peut porter les requêtes cherchées (« usually (but not always) »). La page ne donne aucun nombre ni plafond de recherches par question.
Combien de recherches ChatGPT lance, selon la question
En bref
Sur les 800 réponses du corpus principal de l'AI Sources Index (ChatGPT via l'API, 14 septembre 2026), une question de problème déclenche 0,24 appel de recherche en moyenne et jamais plus d'un. La découverte de solutions en déclenche 1,12, la décision 1,56, la comparaison 1,57 et la recommandation 1,73. C'est la recommandation qui multiplie le plus les recherches.
| Type de question (exemple du corpus) | 0 recherche | 1 | 2 | 3 ou plus | Moyenne | 2 recherches ou plus | Exemple : recherches aux 4 répétitions |
|---|---|---|---|---|---|---|---|
| Problème ou besoin (CRM-002 : « Comment éviter que des prospects soient oubliés par une équipe commerciale B2B ? ») | 121 | 39 | 0 | 0 | 0,24 | 0 % | 0, 0, 0, 0 |
| Découverte de solutions (CRM-005 : « Quels outils permettent de gérer efficacement les prospects et les opportunités commerciales ? ») | 15 | 112 | 32 | 1 | 1,12 | 20,6 % | 1, 1, 1, 1 |
| Recommandation (CRM-009 : « Quels sont les meilleurs CRM pour une PME française ? ») | 9 | 39 | 100 | 12 | 1,73 | 70 % | 2, 3, 2, 2 |
| Comparaison (CRM-014 : « Pipedrive ou HubSpot : lequel est le plus adapté à une équipe commerciale de 20 personnes ? ») | 0 | 83 | 63 | 14 | 1,57 | 48,1 % | 1, 2, 1, 1 |
| Décision ou achat (CRM-017 : « Quel CRM choisir pour une entreprise B2B de 50 salariés ? ») | 2 | 77 | 70 | 11 | 1,56 | 50,6 % | 2, 2, 1, 2 |
| Corpus principal, toutes intentions | 147 | 350 | 265 | 38 | 1,24 | 37,9 % | |
| Expériences de reformulation (200 réponses) | 0 | 107 | 84 | 9 | 1,51 | 46,5 % |
Réponses selon le nombre d'appels à l'outil de recherche (nb_recherches), 160 par type de question ; une seule réponse à 4 recherches (recommandation). Exemples cités mot pour mot de requetes.csv ; la dernière colonne porte sur l'exemple seul. gpt-5.6-terra par l'API, recherche automatique, 14 septembre 2026. Source : Evocia, AI Sources Index 2026 (CC BY 4.0).
Trois lectures. La question de problème reste le plus souvent sans recherche (121 réponses sur 160), ce qu'analyse ChatGPT cherche-t-il toujours sur le web ?. La comparaison cherche toujours, mais une seule fois dans 83 cas sur 160. La recommandation (« les meilleurs X pour Y ») lance au moins deux recherches dans 112 cas sur 160.
Pourquoi la recommandation ? L'étude ne le mesure pas. Hypothèse non testée : « meilleurs CRM pour une PME française » combine une catégorie et des critères à explorer, quand une comparaison nomme déjà les candidats. Autre constat : le nombre de recherches varie plus que la décision de chercher. Sur les 157 requêtes qui ont cherché aux quatre répétitions, 70 seulement (44,6 %) ont lancé le même nombre de recherches à chaque fois.
Ce que ce chiffre compte, et ce qu'il ne compte pas
nb_recherches compte les appels à l'outil de recherche, pas les requêtes que chaque appel contient : le nombre exact de sous-requêtes est indisponible. La mesure vaut pour un modèle, un réglage, des questions d'achat B2B en français et une date ; l'application grand public peut se comporter autrement. La moyenne de 1,52 recherche par réponse avec recherche, et ce qu'elle change au nombre de pages consultées et citées, est sur la page ChatGPT lit 27 pages et en cite 3.
Les chiffres des autres études : pourquoi ils ne s'additionnent pas
En bref
Les guides anglais citent des moyennes de 1,4 à plus de 10 sous-requêtes par question. Elles viennent d'éditeurs d'outils, portent sur d'autres moteurs ou d'autres versions de modèle, et ne comptent pas toujours la même chose. Elles se lisent chacune avec son périmètre ; aucune ne se compare terme à terme à une autre, ni aux mesures d'Evocia.
| Éditeur et date | Moteur | Ce qui est publié | Échantillon et méthode | Limite pour votre lecture |
|---|---|---|---|---|
| Peec AI, données du 1er au 21 avril 2026 | ChatGPT, Perplexity, Grok | 2,1 fan-outs par prompt pour ChatGPT, 1,4 pour Perplexity, 6,8 pour Grok | 5 millions de fan-outs ; méthode non détaillée | Antérieur à GPT-5.6 |
| Peec AI, août 2026 | ChatGPT, GPT-5.5 puis GPT-5.6 (Luna) | Prompts réglés en un seul tour de fan-out : 94,0 % avec GPT-5.5, 43,5 % avec GPT-5.6 ; sources récupérées par prompt passées d'environ 12 à environ 24 | Échantillon non indiqué | Variante Luna, modèle par défaut des offres Free et Go selon Peec ; Evocia a mesuré gpt-5.6-terra par l'API |
| Seer Interactive, 21 novembre 2025 | Gemini 3 par l'API, recherche Google imposée | 10,7 fan-outs par prompt en moyenne (de 3 à 28) ; 6,01 avec Gemini 2.5 | 501 prompts | Recherche forcée |
| Surfer, article mis à jour le 22 octobre 2026 | Gemini avec recherche Google | Environ 27 % des requêtes de fan-out reviennent d'un passage à l'autre du même prompt ; 66 % n'apparaissent qu'une fois, 0,6 % à chaque passage | 1 600 passages ; nombre de prompts et date de mesure non indiqués | Mesure de stabilité, pas de volume |
Pages relues le 17 novembre 2026 : mesures d'éditeurs, non vérifiées par Evocia, citées telles que publiées.
Deux raisons empêchent l'addition. L'unité diffère : une requête de recherche chez Peec ou Seer, un appel à l'outil chez Evocia, qui peut en porter plusieurs. Le moteur et la date diffèrent : Peec écrit que GPT-5.6 a changé la récupération, et Seer force la recherche qu'Evocia laisse au choix du modèle. Le même problème se pose pour la langue des sous-requêtes, traité dans ChatGPT cite-t-il des sources en anglais ?.
Retenez une tendance, pas un chiffre : sur les questions de choix, les moteurs lancent plusieurs recherches, qui changent d'une fois à l'autre. Une page écrite pour une formulation exacte a peu de prise sur ce qui sera cherché.
Section, page ou rien : la grille pour chaque sous-question
En bref
Une sous-question de vos acheteurs se traite de trois façons. Elle devient une section autonome quand elle complète une page qui existe déjà. Elle mérite une page quand elle porte une intention propre et assez de matière utile. Elle ne demande rien quand ce n'est qu'une autre formulation d'une question déjà traitée, ou qu'elle sort de votre offre.
| Situation de la sous-question | Exemple fictif (éditeur de CRM Orvimbe) | Décision | Ce qu'il faut faire |
|---|---|---|---|
| Elle complète une page existante qui n'y répond pas | « Orvimbe s'intègre-t-il à notre suite bureautique ? » alors que la page produit ne le dit pas | Une section | Un intertitre formulé comme la question, une réponse courte en tête, puis le détail |
| Elle a sa propre intention et assez de matière | Hébergement des données et conformité, tarifs, comparaison avec une solution nommée | Une page | Une page utile même sans les IA, reliée aux pages de décision |
| C'est une variante de formulation | « Meilleur CRM pour PME » et « CRM adapté à une PME » | Rien | Pas de page par variante : une seule page solide répond aux deux |
| Elle est déjà traitée, mais enfouie | La réponse sur le prix est noyée dans une longue FAQ | Rien de nouveau | La remonter dans une section visible |
| Elle sort de votre offre | Une fonction que vous ne vendez pas | Rien | Ne pas publier pour la seule chance d'être cité |
Grille d'Evocia : une recommandation, pas une mesure ; aucune étude publiée ne montre qu'elle augmente les citations. Orvimbe est fictif.
Google, guide d'optimisation pour l'IA générative (relu le 17 novembre 2026) : créer des contenus séparés pour chaque variante de recherche, requêtes de fan-out comprises, « primarily to manipulate rankings or generative AI responses in Google Search violates Google's scaled content abuse spam policy ». La page des règles anti-spam définit cet abus (pages produites pour manipuler le classement plutôt que pour aider) et l'abus de pages satellites (« created to rank for specific, similar search queries »).
Nos données donnent un ordre de priorité. Les questions de problème déclenchent rarement une recherche : une page écrite pour elles a peu d'occasions d'être consultée par ChatGPT pendant la réponse. Les recherches se concentrent sur la recommandation, la comparaison et la décision : c'est là qu'une section précise sur l'intégration, le prix ou la conformité peut être consultée. Son effet sur la citation n'est pas mesuré.
Ce que vous pouvez observer vous-même, et ce que vous ne verrez pas
En bref
Par l'API d'OpenAI, chaque appel de recherche peut renvoyer les requêtes cherchées : un développeur peut donc les relever sur vos questions. Dans les pages officielles lues pour ce guide, rien ne décrit un moyen de voir la liste des sous-requêtes dans l'application ChatGPT ou dans le mode IA de Google. Ce qui reste observable par tous, ce sont les réponses.
- Les requêtes de l'API. Posez vos questions d'acheteurs par l'API avec l'outil de recherche et relevez les requêtes renvoyées. Répétez : le nombre de recherches change d'une fois à l'autre.
- Les générateurs de fan-out. Un outil qui « génère » des sous-requêtes à partir d'une question en produit des plausibles avec un modèle de langage. Sauf s'il documente qu'il les capture dans de vraies réponses, ce n'est pas un relevé.
- Les réponses. Relevez sur un panel de questions qui est nommé, recommandé ou cité, avec répétitions. C'est ce qui compte, quelle que soit la mécanique en amont.
Avant de réécrire vos pages pour des sous-requêtes que vous ne voyez pas, regardez ce que les IA répondent sur votre catégorie. Le test de visibilité IA d'Evocia pose trois questions d'acheteurs, plusieurs fois, à ChatGPT et à une ou deux autres IA, et vous dit qui est cité.
Tester ma visibilité IALes 1 000 réponses et le champ nb_recherches sont téléchargeables sur la page de l'AI Sources Index 2026, pour refaire ce calcul sur votre secteur parmi les dix de l'étude.
Questions fréquentes
Qu'est-ce que le query fan-out ?
C'est le découpage d'une question en plusieurs recherches liées, sur des sous-thèmes, dont le moteur rassemble les résultats pour répondre. Google le documente pour ses Aperçus IA et son mode IA ; OpenAI documente que ChatGPT décide de chercher et peut affiner ses recherches, sans employer le terme.
Combien de recherches ChatGPT lance-t-il pour répondre à une question d'achat ?
Dans l'AI Sources Index d'Evocia (gpt-5.6-terra par l'API, 14 septembre 2026, 160 réponses par type de question), la moyenne est de 1,56 appel de recherche pour une décision d'achat, 1,57 pour une comparaison et 1,73 pour une recommandation, contre 0,24 pour une question de problème. Ce sont des appels à l'outil, pas des sous-requêtes.
Faut-il créer une page par sous-requête du query fan-out ?
Non. Le guide de Google sur l'IA générative écrit que créer des contenus séparés pour chaque variante, requêtes de fan-out comprises, principalement pour manipuler les classements ou les réponses d'IA, enfreint sa règle contre l'abus de contenu à grande échelle. Traitez une sous-question par une section, ou par une page si elle a sa propre intention.
Un outil de query fan-out montre-t-il les vraies recherches de ChatGPT ?
Pas forcément. Un générateur produit des sous-requêtes plausibles avec un modèle de langage ; ce n'est un relevé que s'il documente qu'il capture les recherches lancées dans de vraies réponses. Par l'API d'OpenAI, les requêtes de chaque appel de recherche sont souvent renvoyées, mais pas toujours, selon la documentation.
Sources
- Google Search Central, AI features and your website (query fan-out des Aperçus IA et du mode IA), consultée le 17 novembre 2026
- Google Search Central, guide d'optimisation pour l'IA générative (requêtes de fan-out, contenus par variante et abus de contenu à grande échelle), consulté le 17 novembre 2026
- Google Search Central, règles anti-spam (abus de contenu à grande échelle, pages satellites), consultées le 17 novembre 2026
- Google, mise à jour du mode IA (décomposition en sous-thèmes, Deep Search), 20 mai 2025
- OpenAI, guide de l'outil de recherche web de l'API (choix de chercher, actions de recherche et requêtes), consulté le 17 novembre 2026
- Evocia, AI Sources Index 2026 : réponses, requêtes et dictionnaire des données (champ nb_recherches)
- Peec AI, fanouts per prompt by engine (1er au 21 avril 2026), consulté le 17 novembre 2026
- Peec AI, GPT-5.6 retrieval changes (août 2026), consulté le 17 novembre 2026
- Seer Interactive, Initial Research: Gemini 3 Query Fan-Outs (21 novembre 2025), consulté le 17 novembre 2026
- Surfer, What is query fan-out (mis à jour le 22 octobre 2026), consulté le 17 novembre 2026
Transparence et méthode
Auteur
Evocia · Cabinet français de visibilité dans les IA
Evocia est une équipe française de croissance SEO, GEO et AEO : elle mesure et améliore la visibilité des entreprises sur Google et dans les réponses des IA, et publie les données de l'AI Sources Index 2026.
Comment cet article a été réalisé
- Calcul refait le 17 novembre 2026 sur les fichiers ouverts de l'AI Sources Index 2026 : reponses.csv joint à requetes.csv sur id_requete. Pour chaque type de question du corpus principal (dataset A, 160 réponses chacun), on compte les réponses par valeur de nb_recherches (0, 1, 2, puis 3 et 4 réunis en « 3 ou plus ») ; la moyenne est la somme des nb_recherches divisée par 160. Résultat identique au recalcul indépendant de l'agent de recherche (1 000 réponses : 147 à 0, 457 à 1, 349 à 2, 46 à 3, 1 à 4).
- Arrondis : au plus proche, le demi vers le haut, règle de l'étude. Moyennes à deux décimales (250/160 = 1,5625 donne 1,56), parts à une décimale (77/160 = 48,125 % donne 48,1 %). Stabilité du nombre : parmi les 157 requêtes du corpus principal qui ont cherché aux quatre répétitions, 70 ont le même nb_recherches aux quatre.
- nb_recherches est défini par le dictionnaire de l'étude comme le « nombre d'appels à l'outil de recherche » ; le texte des requêtes envoyées n'est pas publié. Les chiffres de tiers sont repris des pages des éditeurs relues le 17 novembre 2026, sans vérification de leurs données. L'explication de l'écart entre recommandation et comparaison est une hypothèse, non testée.
Historique des mises à jour
- 17 novembre 2026Publication initiale : définition du query fan-out et ce qu'en documentent Google et OpenAI ; répartition du nombre d'appels de recherche de ChatGPT par type de question, recalculée sur les 1 000 réponses ouvertes de l'AI Sources Index 2026 ; chiffres de Peec, Seer et Surfer avec leur périmètre ; grille « section, page ou rien » ; ce qui est observable ou non.