Comment savoir si les IA lisent votre site, et pourquoi lu ne veut pas dire cité
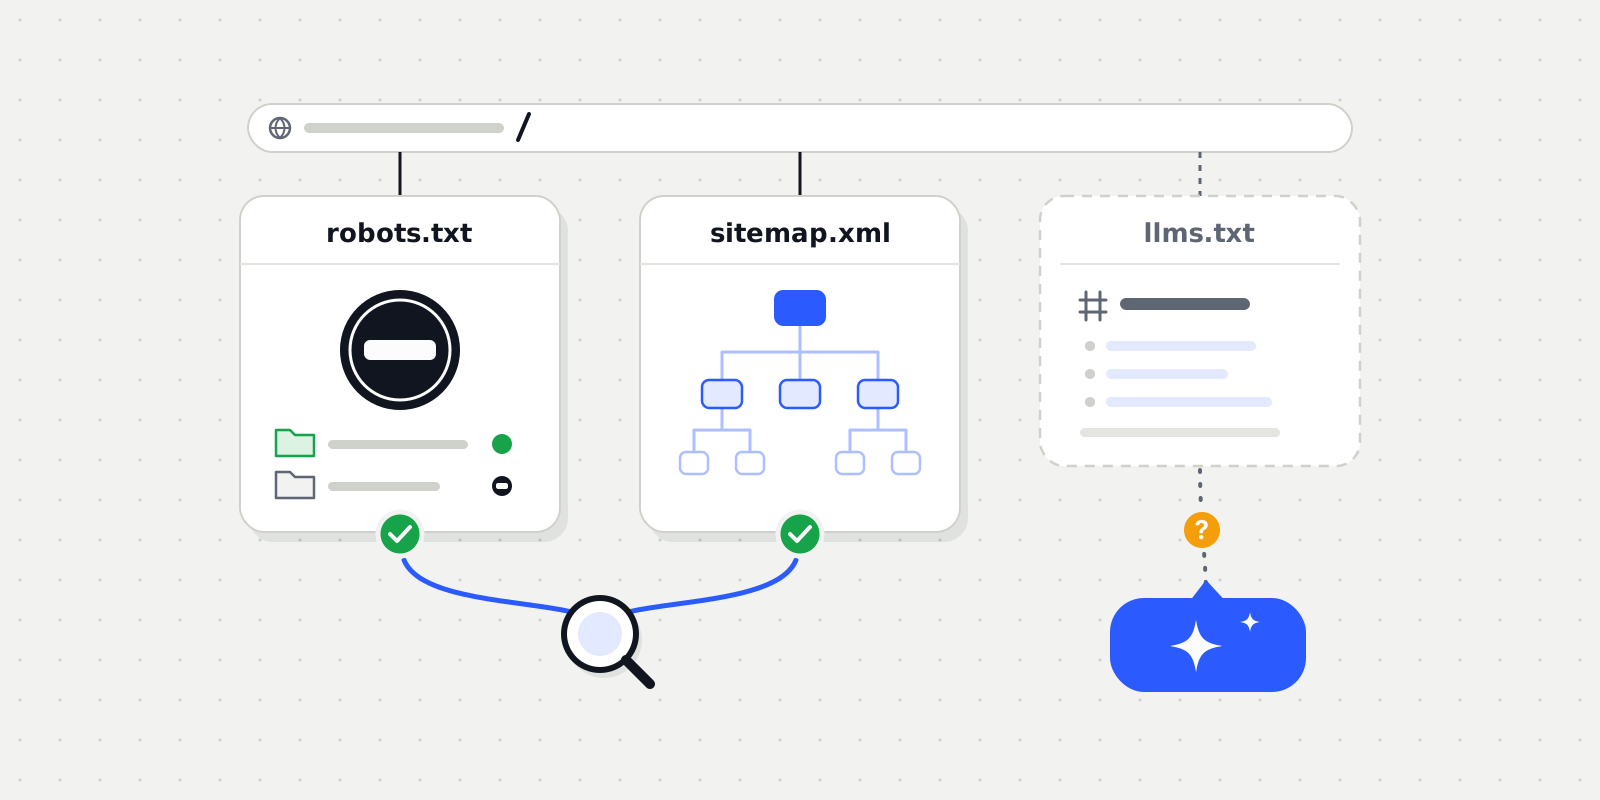
La question « est-ce que ChatGPT lit mon site ? » n'a pas une réponse mais trois, parce qu'elle recouvre trois faits distincts. Votre robots.txt dit ce que vous autorisez : c'est une déclaration, pas une observation. Vos journaux serveur disent qui est réellement venu, quand, et avec quel code de réponse : c'est la seule preuve de passage. Le code source brut de vos pages dit ce que le robot a pu lire sans exécuter de JavaScript : c'est la seule preuve d'exploitabilité. Les trois se vérifient en quelques minutes, dans cet ordre.
Notre recommandation : faites ces contrôles avant tout autre chantier de visibilité, une fois et bien, parce qu'ils coûtent peu et ferment une cause d'absence totale. Les robots à regarder n'ont pas le même effet : ceux d'index de recherche conditionnent votre présence dans les réponses, GPTBot et ClaudeBot ne concernent que l'entraînement, et Google-Extended n'est même pas un robot.
Constater un accès n'est pas constater une citation. Dans l'AI Sources Index 2026 d'Evocia, les réponses de ChatGPT qui déclenchent une recherche web lisent 27 pages en moyenne et en citent 3,4. Reddit est lu dans 100 réponses et cité dans aucune ; Wikipédia dans 85, et cité dans aucune. L'accès est un prérequis, jamais un résultat.
L'essentiel en 60 secondes
- Trois vérifications, trois questions différentes : robots.txt dit ce que vous autorisez, les journaux serveur disent qui est passé et avec quel code de réponse, le code source brut dit ce que le robot a pu lire sans JavaScript.
- Les robots n'ont pas le même rôle. Chez OpenAI, OAI-SearchBot alimente la recherche de ChatGPT, GPTBot l'entraînement, ChatGPT-User la lecture déclenchée par un utilisateur : bloquer le robot d'entraînement ne vous retire pas de la recherche.
- Deux agents déclarent que robots.txt peut ne pas s'appliquer quand c'est un utilisateur qui demande la page : ChatGPT-User (« les règles de robots.txt peuvent ne pas s'appliquer ») et Perplexity-User (« ignore généralement les règles de robots.txt »).
- Google-Extended n'est pas un robot : Google le documente comme un jeton de contrôle autonome, sans user-agent propre, qui porte sur l'usage de vos contenus pour Gemini et n'affecte ni la présence ni le classement dans Google Search.
- Un blocage peu visible n'est pas dans robots.txt mais dans le pare-feu ou le service de protection, qui refuse en silence. Il ne se voit que dans les journaux, sous forme de 403, 429 ou 503 au nom du robot.
- La limite est franche : sur les réponses mesurées qui déclenchent une recherche, ChatGPT lit 27 pages et en cite 3,4. Vérifier l'accès élimine une cause d'absence ; cela ne produit aucune citation.
Les trois niveaux de vérification, dans l'ordre
En bref
Vérifiez d'abord votre robots.txt : il dit, robot par robot, ce que vous autorisez. Vérifiez ensuite vos journaux serveur : ils disent qui est réellement passé et avec quel code de réponse, et c'est la seule preuve de passage. Vérifiez enfin le code source brut de vos pages stratégiques : il dit ce que le robot a pu lire sans exécuter de JavaScript. Un échec au niveau 1 rend les deux autres sans objet.
| Niveau | La question à laquelle il répond | Comment le vérifier | Ce qu'il ne dit pas |
|---|---|---|---|
| 1. Fichier d'exclusion | Qu'autorisez-vous, robot par robot ? | Ouvrir votre-domaine.fr/robots.txt et lire les groupes User-agent qui concernent chaque robot | Si le robot est réellement venu |
| 2. Journaux serveur | Qui est venu, quand, et avec quel code de réponse ? | Filtrer les journaux par user-agent, vérifier l'identité de l'appelant, relever les codes de réponse | Si ce qui a été lu était exploitable |
| 3. Rendu servi | Qu'a reçu le robot au bout de la ligne ? | Afficher le code source brut de la page (pas l'inspecteur, qui montre la page après exécution du JavaScript) et y chercher le texte essentiel | Si la page sera citée |
Trois niveaux, trois objets : une déclaration, une observation, un contenu. Ils ne sont pas interchangeables, et le premier échec est la priorité : inutile de travailler le rendu d'une page qu'aucun robot n'atteint.
Niveau 1 : lire votre robots.txt comme un robot le lit
Ouvrez l'adresse /robots.txt de votre domaine, et de chaque origine que vous servez : un fichier par protocole, hôte et port. Un robot nommé dans un groupe suit ce groupe et lui seul, et ignore intégralement le groupe « User-agent: * » : oublier de répliquer vos règles générales dans un groupe nommé est l'erreur classique. Une absence de fichier, répondue en 404, signifie que tout est autorisé par défaut. La syntaxe complète, les jokers et le piège du blocage qui empêche de voir un noindex sont détaillés dans le guide robots.txt, sitemap.xml et llms.txt. Pour faire cette lecture sans erreur de groupe, Robots IA, l'outil gratuit d'Evocia, applique votre fichier à chaque robot documenté par son exploitant, chaque verdict avec sa source officielle.
Niveau 2 : constater le passage dans les journaux
Les journaux d'accès de votre serveur, de votre hébergeur ou de votre réseau de diffusion de contenu (CDN) sont la seule source qui prouve un passage. Filtrez sur les noms d'agents, puis regardez deux colonnes : la date, qui dit la fréquence de visite, et le code de réponse, qui dit si la page a été servie. Un 200 signe un accès réussi ; un 403, un 429 ou un 503 signe un refus que votre robots.txt n'explique pas. Vérifiez aussi l'identité de l'appelant : le champ user-agent est déclaratif et s'usurpe. OpenAI, Anthropic et Perplexity publient les plages d'adresses de leurs robots ; Google et Microsoft documentent la vérification par résolution DNS inverse, et Google publie en plus ses plages au format JSON.
Niveau 3 : regarder ce que le robot reçoit
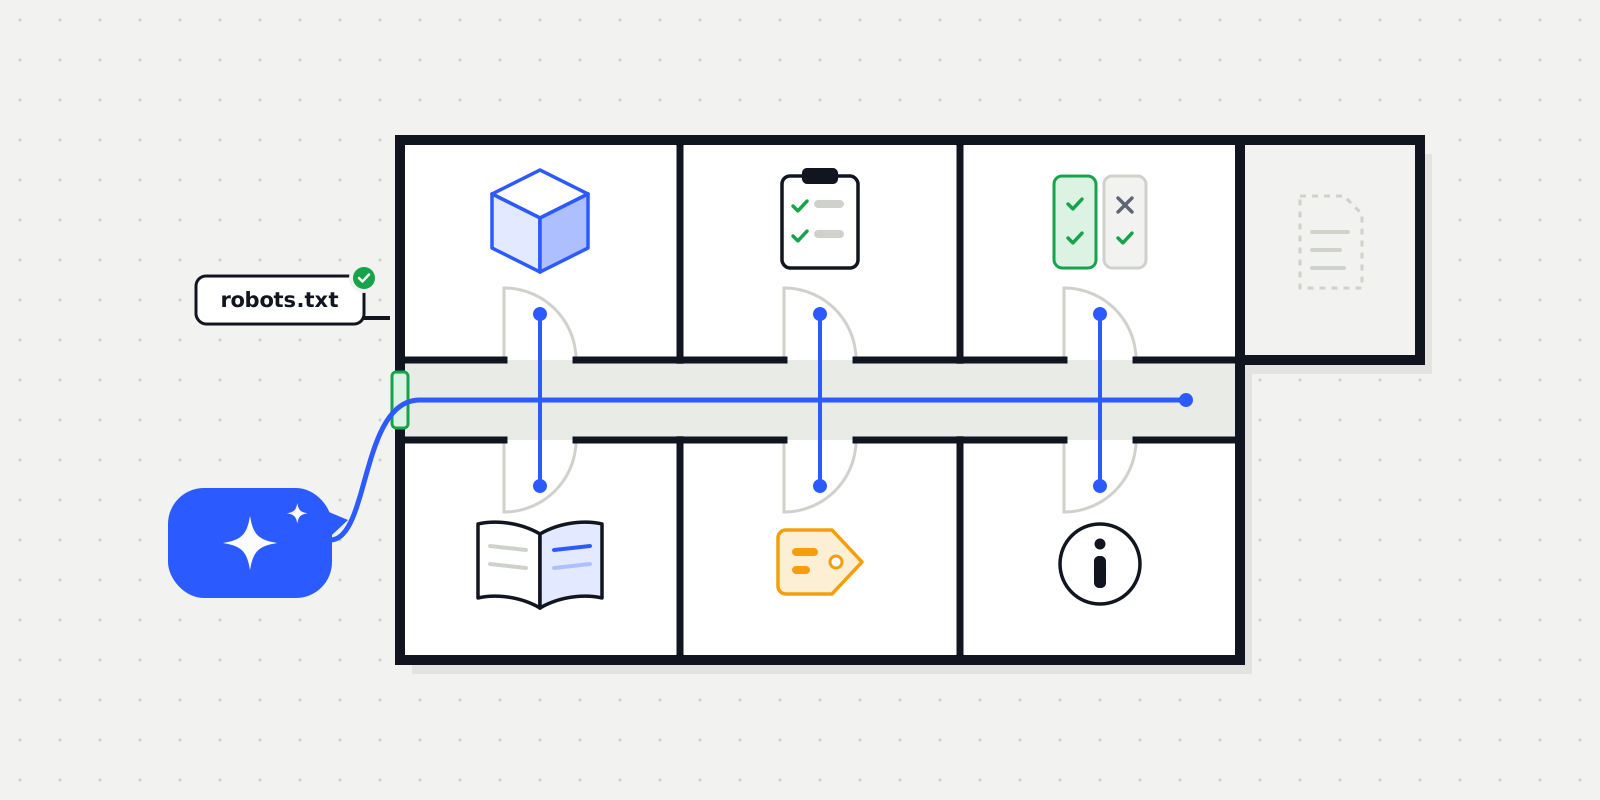
Un accès autorisé et constaté peut encore ne rien donner, si la page ne contient aucun texte avant exécution du JavaScript. Affichez le code source brut de vos pages stratégiques, pas l'inspecteur du navigateur, et cherchez-y vos titres, vos définitions, vos chiffres. À la dernière mesure publique d'ampleur, en décembre 2024, aucun robot d'IA dédié n'exécutait le JavaScript : un contenu rendu uniquement côté client leur est invisible. Les conséquences d'architecture sont traitées dans le guide comment optimiser son site pour ChatGPT et les IA.
Les robots à vérifier et ce que chacun fait
En bref
Onze jetons méritent une décision consciente, et ils n'ont pas le même effet. Les robots d'index de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot, Bingbot) conditionnent votre présence dans les réponses. Les agents déclenchés par un utilisateur (ChatGPT-User, Claude-User, Perplexity-User) lisent une page à la demande. GPTBot et ClaudeBot ne servent qu'à l'entraînement. Google-Extended n'est pas un robot mais un jeton de contrôle.
| Exploitant | Jeton dans robots.txt | Fonction documentée | Respect de robots.txt, tel que déclaré |
|---|---|---|---|
| OpenAI | OAI-SearchBot | Faire apparaître des sites dans les résultats des fonctions de recherche de ChatGPT ; un site qui le bloque n'est plus montré dans les réponses de recherche, mais peut encore apparaître en lien de navigation | Oui |
| OpenAI | ChatGPT-User | Visite d'une page quand un utilisateur pose une question à ChatGPT ou à un GPT personnalisé ; OpenAI précise qu'il ne sert pas à décider de l'apparition dans la recherche | Non garanti : l'action étant lancée par un utilisateur, « les règles de robots.txt peuvent ne pas s'appliquer » |
| OpenAI | GPTBot | Exploration de contenus susceptibles de servir à l'entraînement des modèles de fondation | Oui |
| Anthropic | Claude-SearchBot | Parcours du web pour améliorer la qualité des résultats de recherche proposés aux utilisateurs | Oui : respect des directives standard de robots.txt, Crawl-delay compris |
| Anthropic | ClaudeBot | Collecte de contenus web pour l'utilité et la sûreté des modèles génératifs | Oui, même déclaration |
| Anthropic | Claude-User | Visite d'une page quand un utilisateur pose une question à Claude | Oui : Anthropic déclare que ses trois agents respectent robots.txt |
| Perplexity | PerplexityBot | Faire apparaître et lier des sites dans les résultats de Perplexity ; explicitement pas de l'entraînement de modèles de fondation | La documentation présente robots.txt comme le moyen de gérer cet accès et recommande de l'autoriser, sans parler de respect strict |
| Perplexity | Perplexity-User | Visite d'une page à la demande d'un utilisateur, pour fonder une réponse | Non : « puisqu'un utilisateur a demandé la récupération, cet agent ignore généralement les règles de robots.txt » |
| Googlebot | Exploration du web pour constituer les index de Google Search et de ses produits | Oui | |
| Google-Extended | Jeton de contrôle autonome, sans user-agent propre : usage des contenus pour l'entraînement et l'ancrage des modèles Gemini | Oui, en tant que jeton de contrôle ; aucun effet sur la présence ni sur le classement dans Google Search | |
| Microsoft | Bingbot | Découverte des documents nouveaux et mis à jour pour l'index de Bing, dont Microsoft relie la fraîcheur aux réponses générées par l'IA | Oui, directives de robots.txt prises en charge |
Noms, rôles et déclarations repris des documentations des exploitants, consultées le 1er octobre 2026 et relues le 6 novembre 2026 (liens en sources). Les citations entre guillemets sont traduites de l'anglais.
Deux conséquences contre-intuitives tiennent à ce tableau. Bloquer GPTBot ne vous retire pas des réponses de recherche de ChatGPT : c'est OAI-SearchBot qui en décide, ChatGPT-User n'étant pas utilisé pour cela, et OpenAI sépare explicitement les deux contrôles. Et bloquer Google-Extended n'a aucun effet sur votre présence dans Google Search, puisque Google documente ce jeton comme un contrôle d'usage pour Gemini, et non comme un robot d'exploration. Pour sortir des Aperçus IA et d'AI Mode, le réglage est ailleurs : le contrôle d'IA générative de la Search Console, ouvert à tous les sites depuis le 31 août 2026.
Attention
Un jeton d'agent déclenché par un utilisateur ne se traite pas comme un robot d'exploration : OpenAI et Perplexity écrivent tous deux que robots.txt peut ne pas s'y appliquer. Si vous voulez empêcher ces lectures, le contrôle n'est pas déclaratif : il est dans le pare-feu, l'authentification ou la limitation de débit, et il se vérifie dans les journaux.
Deux agents hors de ce tableau
OAI-AdsBot ne visite que les pages soumises comme annonces sur ChatGPT : il ne vous concerne que si vous y diffusez des annonces. Claude-Agent est un jeton ajouté à l'en-tête d'un vrai navigateur hébergé par Anthropic quand Claude accomplit une tâche pour un utilisateur : Anthropic le traite à part de ses robots et publie ses adresses. Pages relues le 6 novembre 2026.
Ce qu'un blocage par pare-feu ou par CDN produit, et comment le voir
En bref
Un blocage courant n'est pas écrit dans votre robots.txt : il vient du pare-feu applicatif, du service anti-robots ou des règles du CDN, qui refusent les user-agents inconnus sans rien annoncer. Le symptôme est un robots.txt irréprochable et aucune citation. Il ne se constate que dans les journaux, par des codes 403, 429 ou 503 au nom du robot, ou par l'absence totale de ses requêtes.
| Ce que vous observez | Interprétation la plus probable | Où agir |
|---|---|---|
| Requêtes du robot avec un code 200 | Accès effectif : le niveau 1 et le niveau 2 sont acquis | Passer au niveau 3, le contenu servi |
| Requêtes du robot avec un code 403 | Refus explicite d'une couche en amont, souvent une règle de réputation ou de filtrage de user-agent | Règles du pare-feu applicatif ou du service de protection |
| Requêtes du robot avec un code 429 ou 503 | Limitation de débit ou protection contre les pics, appliquée au robot comme à un attaquant | Seuils de limitation, liste d'exemption des robots vérifiés |
| Page de défi ou de vérification renvoyée en 200 | Le robot reçoit une page d'interstitiel, non votre contenu : l'accès est compté comme réussi à tort | Règles de défi, à désactiver pour les robots vérifiés |
| Aucune requête du robot, sur plusieurs semaines | Blocage au niveau du réseau, ou simple absence de découverte du site | Filtrage par adresse en amont, puis maillage interne et sitemap |
Grille de lecture des journaux, construite pour l'audit d'accès. Le quatrième cas est le plus trompeur : un code 200 ne garantit pas que votre contenu a été servi, seul le corps de la réponse le dit.
Un point d'honnêteté : ces diagnostics se posent sur vos journaux, pas de l'extérieur. Personne ne peut constater à votre place qu'un robot reçoit un 403, parce que cette information n'existe que chez vous. C'est aussi pourquoi un robots.txt propre ne suffit pas à conclure : il décrit une intention, la couche réseau décide.
Sur un site WordPress, le robots.txt servi peut aussi venir d'un fichier physique, de l'extension SEO ou d'un réglage de blocage des robots d'IA : voir les réglages de Yoast, Rank Math et AIOSEO qui comptent pour les IA.
Lu n'est pas cité : 27 pages lues pour 3,4 citées par réponse
En bref
Un accès vérifié ne produit pas une citation, et l'écart est mesurable. Dans l'AI Sources Index 2026 d'Evocia, sur les 853 réponses de ChatGPT ayant déclenché une recherche web, le moteur consulte 27 pages en moyenne par réponse et en cite 3,4. Une page lue sur huit devient une source affichée (12,5 %). Être lu place votre page dans l'ensemble des candidats, et rien de plus.
| Étape de l'entonnoir | Mesure par réponse | Ce que cela change pour vous |
|---|---|---|
| Accès autorisé | Condition binaire, vérifiée par robots.txt et les journaux | Sans lui, vous êtes hors jeu ; avec lui, vous entrez dans le vivier |
| Pages consultées | 27 en moyenne, sur 4,5 domaines | Vous concourez avec une trentaine de pages |
| Pages citées | 3,4 | Trois ou quatre places à prendre par réponse |
Source : Evocia, AI Sources Index 2026 (1 000 réponses ChatGPT, 250 requêtes B2B répétées quatre fois, collecte du 14 septembre 2026, données ouvertes). Le détail de l'entonnoir est dans l'analyse dédiée.
La conséquence pratique est une hiérarchie des chantiers. Vérifier l'accès coûte quelques minutes et élimine une cause d'absence totale : c'est à faire d'abord, et une seule fois bien. Passer de « lu » à « cité » est un travail d'une autre nature, qui porte sur ce que votre page apporte à la réponse. L'écart complet entre pages consultées et pages citées est détaillé dans ChatGPT lit 27 pages et en cite 3, et le mécanisme de sélection dans comment fonctionnent les moteurs génératifs.
La preuve par l'exemple : Reddit lu dans 100 réponses, cité dans aucune
En bref
Deux domaines montrent que l'accès n'achète rien. Sur les 853 réponses avec recherche de l'AI Sources Index 2026, ChatGPT a lu des pages de Reddit dans 100 réponses et n'a cité Reddit dans aucune. Il a lu des pages de Wikipédia dans 85 réponses, et n'a cité Wikipédia dans aucune. Ces deux sites sont parfaitement accessibles, massivement lus, et absents des sources affichées sur ce corpus B2B.
| Domaine | Réponses où il est lu | Réponses où il est cité |
|---|---|---|
| reddit.com | 100 | 0 |
| wikipedia.org | 85 | 0 |
| youtube.com | 23 | 0 |
| arxiv.org | 21 | 0 |
Les quatre domaines les plus consultés jamais cités, sur les 853 réponses ayant déclenché une recherche. Lecture mesurée sur les pages renvoyées par l'outil de recherche, citation mesurée sur les annotations de source. Source : Evocia, AI Sources Index 2026.
Ce constat est propre au corpus mesuré, 250 requêtes d'achat de logiciels B2B en français : il ne dit pas que Reddit n'est jamais cité sur le web, il dit que sur ces questions, le moteur l'a lu sans le retenir. Le cas est détaillé dans ChatGPT cite-t-il Reddit ?. Pour votre site, la leçon se transpose directement : constater que vos pages sont lues est une bonne nouvelle, pas une position.
Le mécanisme de sélection qui écarte un domaine lu n'est documenté par aucun éditeur ; seul l'écart est observable.
Ce que le test de visibilité Evocia vérifie déjà
En bref
Pour l'accès des robots, le test de visibilité IA d'Evocia fait automatiquement le niveau 1. Il lit le fichier /robots.txt de votre domaine, puis celui du sous-domaine www, et dit pour neuf agents documentés si les règles les autorisent, les restreignent ou les bloquent, en citant la règle qui fonde le statut. Il ne lit pas vos journaux, ne juge pas votre rendu et n'affirme rien sur vos citations.
| Vérification | Faite par le test | Pourquoi |
|---|---|---|
| Lecture de /robots.txt (domaine nu, puis www) | Oui | Fichier public, lecture bornée en taille et en durée ; aucune autre adresse n'est lue |
| Statut par agent : autorisé, restreint, bloqué | Oui, pour neuf agents | OAI-SearchBot, ChatGPT-User, GPTBot, PerplexityBot, Perplexity-User, Claude-SearchBot, ClaudeBot, Google-Extended, Bingbot |
| Distinction entre règle nommée et règles générales | Oui | Un agent non nommé suit le groupe « * » : le test le signale au lieu de l'affirmer autorisé sans réserve |
| Fusion des groupes visant le même jeton | Oui | Conformité à la RFC 9309 : deux groupes « * » dont le second bloque tout donnent bien « bloqué » |
| Lecture de vos journaux serveur | Non | Ces données n'existent que chez vous ; aucun service externe n'y accède |
| Jugement du rendu ou du JavaScript | Non | Le test lit la page d'accueil pour proposer une catégorie, il n'évalue pas le rendu |
| Prédiction d'une citation | Non | Aucune promesse de citation n'est faite, à aucune étape |
Périmètre exact du contrôle d'accès du test au 1er octobre 2026. Trois cas sont rendus explicitement : fichier absent, donc tout est autorisé par défaut ; fichier illisible après erreur réseau ou serveur, donc aucun statut n'est affirmé ; fichier tronqué à la lecture, donc signalé comme tel.
Ce périmètre est volontairement étroit, pour une raison de méthode : un outil externe peut lire un fichier public, il ne peut pas constater un passage. Dire « vos robots sont autorisés » est vérifiable ; dire « ChatGPT lit votre site » ne l'est pas depuis l'extérieur. Les niveaux 2 et 3 restent à faire chez vous, et le reste du test porte sur une autre question : ce que les moteurs répondent réellement sur des requêtes de votre catégorie.
Vous voulez savoir ce que les règles de votre site autorisent, agent par agent, puis qui les moteurs citent à votre place sur trois questions de votre catégorie ? Le test gratuit d'Evocia fait les deux, sans promesse de citation.
Vérifier l'accès des robots à mon siteCe que la vérification d'accès ne dit pas
En bref
Un accès vérifié ne dit ni que votre page a été comprise, ni qu'elle a été retenue, ni qu'elle le restera. Il ne dit rien non plus de ce que le modèle sait de vous sans chercher, ni de ce qui se passe dans les moteurs dont vous ne voyez pas les robots. La vérification d'accès ferme une hypothèse d'absence ; elle n'ouvre aucune garantie.
- Elle ne mesure pas la citation. Les journaux montrent des requêtes, pas des réponses. La seule façon de savoir si vous êtes cité est d'interroger les moteurs sur des requêtes de votre catégorie et de relever les sources affichées, plusieurs fois : la méthode est dans comment mesurer sa visibilité dans ChatGPT et les IA.
- Elle ne couvre pas la connaissance apprise. Une réponse donnée sans recherche web ne lit aucune page : elle restitue ce que le modèle a retenu de corpus explorés des mois plus tôt. Aucune vérification d'accès, aujourd'hui, ne renseigne sur ce stock : pour le connaître, il faut interroger le moteur, avec une grille de relevé des questions qui vous nomment.
- Elle ne voit pas tous les chemins. Un moteur peut atteindre votre contenu par un index tiers, par une reprise sur un autre site ou par un agent qui ne s'annonce pas. L'absence de requêtes d'un robot n'est pas la preuve que le moteur ignore votre site.
- Elle est datée. Les jetons, leurs finalités et leurs déclarations de respect changent sans préavis. Les rôles de cet article sont ceux documentés le 6 novembre 2026 ; en cas de doute, la documentation de l'exploitant prime sur ce résumé.
- Elle ne remplace pas la décision. Autoriser un robot d'entraînement est un arbitrage de propriété intellectuelle, pas une action de visibilité. Les deux décisions sont indépendantes, et les confondre conduit à bloquer ce qu'il fallait laisser passer.
La formule à retenir
La vérification d'accès répond à « puis-je être lu ? ». Elle ne répond jamais à « suis-je cité ? ».
Questions fréquentes
Comment savoir si ChatGPT lit mon site ?
En trois étapes. Lisez votre robots.txt pour vérifier que OAI-SearchBot et ChatGPT-User ne sont ni bloqués ni restreints par une règle qui les concerne. Cherchez ensuite leurs requêtes dans vos journaux serveur, avec leurs codes de réponse, en vérifiant l'identité de l'appelant contre les plages d'adresses publiées par OpenAI. Affichez enfin le code source brut de vos pages stratégiques pour confirmer que le texte essentiel y figure sans JavaScript. Les journaux sont la seule preuve de passage : le reste est une déclaration ou une capacité.
Comment vérifier que GPTBot visite mon site ?
Filtrez vos journaux d'accès sur la chaîne « GPTBot », puis vérifiez que les adresses appelantes figurent bien dans la liste publiée par OpenAI, pour écarter une usurpation de user-agent. Deux remarques utiles : l'absence de GPTBot ne dit rien de votre présence dans les réponses de ChatGPT, qui dépend d'autres agents ; et un site récent ou peu lié de l'extérieur peut simplement n'avoir pas encore été découvert.
Quelle est la différence entre OAI-SearchBot et ChatGPT-User ?
Leurs finalités sont documentées comme distinctes. OAI-SearchBot alimente l'index qui fait apparaître des sites dans les fonctions de recherche de ChatGPT : c'est lui qui conditionne votre présence. ChatGPT-User visite une page au moment où un utilisateur pose une question, et OpenAI précise qu'il ne sert pas à décider de l'apparition dans la recherche. Conséquence pratique : OpenAI précise que, l'action étant lancée par un utilisateur, les règles de robots.txt peuvent ne pas s'appliquer à ChatGPT-User. Vous pouvez donc voir des visites de cet agent alors même que vos règles le restreignent.
Mon robots.txt est correct mais aucun robot ne passe : pourquoi ?
Trois causes, à vérifier dans cet ordre. Une couche en amont refuse : pare-feu applicatif, service anti-robots ou règles de CDN, qui renvoient un 403, un 429 ou une page de défi au nom du robot. Le site n'est pas découvert : pas de liens entrants, pas de sitemap déclaré, pages orphelines. Ou vos journaux ne couvrent pas la bonne couche : si un CDN sert la page sans joindre l'origine, ses journaux sont les seuls à montrer la requête.
Faut-il bloquer les robots d'entraînement comme GPTBot et ClaudeBot ?
C'est un arbitrage, pas une consigne de visibilité. GPTBot et ClaudeBot sont documentés comme servant à l'entraînement des modèles : les bloquer ne vous retire pas des réponses de recherche de ChatGPT ni de Claude, qui dépendent d'autres agents. La décision relève donc de votre position sur l'usage de vos contenus, et elle est indépendante de celle que vous prenez sur les robots d'index de recherche. Un signal commun de refus de l'entraînement, issu d'un brouillon de l'IETF, s'ajoute à ces jetons : Anthropic dit le reconnaître depuis le 30 octobre 2026, une règle nommant ClaudeBot restant prioritaire, et Google vise 2027. Ce n'est pas encore un standard : gardez vos règles nommées.
Si les robots lisent mon site, serai-je cité ?
Non, et l'écart est chiffré. Sur les 853 réponses de ChatGPT ayant déclenché une recherche dans l'AI Sources Index 2026 d'Evocia, 27 pages sont lues par réponse et 3,4 citées. Deux domaines parfaitement accessibles illustrent la limite : Reddit, lu dans 100 réponses et cité dans aucune, et Wikipédia, lu dans 85 et cité dans aucune. L'accès est une condition d'entrée dans le vivier des candidats ; la citation se joue ensuite sur ce que la page apporte à la réponse.
Sources
- IETF, brouillon draft-kelley-aipref-training-preference-signal-00 (document de travail), consultée le 6 novembre 2026
- Google Search Central, contrôle commun de l'entraînement dans robots.txt (30 octobre 2026), consultée le 6 novembre 2026
- Google, nouveaux contrôles pour les propriétaires de sites (3 juin 2026, déployés à tous les sites le 31 août 2026), consultée le 6 novembre 2026
- Google, contrôler ce que vous partagez avec la recherche (contrôle d'IA générative de la Search Console), consultée le 6 novembre 2026
- Anthropic, navigateurs hébergés et jeton Claude-Agent, consultée le 6 novembre 2026
- OpenAI, documentation des robots (OAI-SearchBot, ChatGPT-User, GPTBot, OAI-AdsBot, plages d'adresses publiées), relue le 6 novembre 2026
- Anthropic, exploration du web et blocage (ClaudeBot, Claude-SearchBot, Claude-User, respect de robots.txt, signal sur l'entraînement), relue le 6 novembre 2026
- Perplexity, documentation des robots (PerplexityBot, Perplexity-User qui ignore généralement robots.txt), relue le 6 novembre 2026
- Google, robots communs et jeton Google-Extended (jeton de contrôle sans user-agent, sans effet sur Search), relue le 6 novembre 2026
- Google, vérifier Googlebot et les autres robots (résolution DNS inverse, plages d'adresses JSON), relue le 6 novembre 2026
- Microsoft, bingbot et l'efficacité d'exploration (découverte des contenus nouveaux et mis à jour), relue le 6 novembre 2026
- Microsoft, sitemaps et découvrabilité dans la recherche augmentée par l'IA (fraîcheur et réponses générées), relue le 6 novembre 2026
- Microsoft, prise en charge de la directive Crawl-delay par bingbot
- IETF, RFC 9309 : Robots Exclusion Protocol (groupes, fusion, correspondance la plus longue)
- Google, introduction à robots.txt (ce que le fichier fait et ne fait pas)
- Vercel et MERJ, The Rise of the AI Crawler (rendu JavaScript des robots d'IA, décembre 2024)
- Evocia, AI Sources Index 2026 (1 000 réponses ChatGPT, collecte du 14 septembre 2026, données ouvertes)
Transparence et méthode
Auteur
Evocia · Cabinet français de visibilité dans les IA
Evocia mesure la présence des entreprises dans les réponses de ChatGPT, Claude, Gemini, Perplexity et Copilot. Le contrôle d'accès décrit ici est celui qu'Evocia exécute en ouverture de chaque audit, avant toute mesure de citation.
Comment cet article a été réalisé
- Les noms, rôles et déclarations de respect de robots.txt des onze jetons de cet article ont été relevés sur les documentations des exploitants le 1er octobre 2026 et relus le 6 novembre 2026 : OpenAI, Anthropic, Perplexity, Google et Microsoft. Les URL exactes sont en sources ; les formulations entre guillemets sont traduites de l'anglais et vérifiées une à une sur la page citée.
- Les chiffres de lecture et de citation viennent du jeu de données de l'AI Sources Index 2026 d'Evocia (1 000 réponses de ChatGPT, 250 requêtes d'achat de logiciels B2B en français répétées quatre fois, collecte du 14 septembre 2026) : 27 pages consultées et 3,4 citées par réponse ayant déclenché une recherche, sur 853 réponses concernées ; Reddit consulté dans 100 réponses et cité dans aucune, Wikipédia dans 85 et cité dans aucune. Aucune valeur n'est recalculée ni arrondie autrement que dans l'export de l'étude.
- La description du périmètre du test de visibilité IA correspond au comportement réel du service au 1er octobre 2026 : lecture du seul fichier /robots.txt, neuf agents évalués, fusion des groupes visant le même jeton, trois cas d'incertitude rendus explicites. Rien n'y est annoncé que le service ne fasse, et le test n'affirme aucune citation.
- La grille de lecture des journaux est une construction méthodologique Evocia, destinée à l'audit d'accès : elle ordonne des causes observables, elle ne mesure rien. Aucune statistique inventée, aucun effet non démontré présenté comme acquis, aucune promesse de citation.
Historique des mises à jour
- 12 novembre 2026Niveau 1 de la vérification : lien vers l'outil gratuit Robots IA. Lien contextuel ajouté vers l'article sur les réglages WordPress (Yoast, Rank Math, AIOSEO), après la grille de lecture des journaux.
- 11 novembre 2026Vocabulaire : l'AEO est nommé avec le GEO (étiquettes de l'article), sans autre changement de fond.
- 6 novembre 2026Pages des exploitants relues le 6 novembre 2026. Correction d'exactitude : OpenAI précise que ChatGPT-User ne sert pas à décider de l'apparition dans la recherche, c'est OAI-SearchBot qui en décide ; le tableau, le bloc de preuve et la FAQ le disent, ainsi que le lien de navigation qui reste possible après un blocage. La ligne PerplexityBot suit la documentation, qui présente robots.txt comme le moyen de gérer l'accès. Ajouts : OAI-AdsBot et Claude-Agent, hors du tableau ; le contrôle d'IA générative de la Search Console pour sortir des Aperçus IA et d'AI Mode ; le signal commun de refus de l'entraînement (Anthropic depuis le 30 octobre 2026, Google en 2027). L'introduction remplace l'annonce de plan par la recommandation : ces contrôles passent avant tout autre chantier. L'essentiel ne qualifie plus de fréquent un blocage dont la fréquence n'est pas mesurée ; une phrase de méthode, redondante avec la légende, et une formule de fin sont retirées. Liens mis à jour vers les nouvelles adresses de Perplexity et de Google. Aucun chiffre de l'étude modifié.
- 4 novembre 2026Dans la section sur ce que la vérification d'accès ne dit pas, un renvoi vers le guide de relevé des questions qui nomment l'entreprise. Rien d'autre ne change.
- 5 octobre 2026Claude-User, l'agent qu'Anthropic utilise quand un utilisateur demande une page, entre dans le tableau des robots : l'article décrit désormais onze jetons. L'introduction précise que deux robots, GPTBot et ClaudeBot, ne servent qu'à l'entraînement. Nous ne disposons d'aucune mesure sur la fréquence des causes de blocage : le pare-feu est présenté comme une cause courante et peu visible, et la FAQ liste les causes dans l'ordre où les vérifier. Le rapport entre pages lues et pages citées est corrigé : une page lue sur huit devient une source affichée (12,5 %), et non une sur neuf. ChatGPT-User déclare que robots.txt « peut ne pas s'appliquer » : l'essentiel ne dit plus qu'il ne le suit pas.
- 1er octobre 2026Publication initiale : trois niveaux de vérification (fichier d'exclusion, journaux serveur, rendu servi), tableau des dix jetons avec rôle documenté et déclaration de respect de robots.txt, grille de lecture des codes de réponse en cas de blocage par pare-feu ou CDN, entonnoir lu contre cité (27 pages pour 3,4 citées), quatre domaines lus et jamais cités, périmètre exact du contrôle d'accès du test Evocia, et cinq limites de la vérification d'accès.