HubSpot AEO Grader : ce que mesure vraiment le score sur 100, et ce qu'il ne dit pas de votre visibilité GEO
Le score du HubSpot AEO Grader mesure la perception de votre marque par trois modèles d'IA, pas votre présence dans les réponses que lisent vos acheteurs. HubSpot l'écrit lui-même : l'outil montre ce que les moteurs disent de vous « based on their training data », sous forme d'un « one-time snapshot ». Il ne publie ni les questions posées, ni le nombre de répétitions, ni de marge d'erreur.
Notre position : lisez-le comme un contrôle d'image gratuit, utile pour repérer une erreur ou un mauvais rangement de votre marque. Ne le montrez pas à votre direction comme une mesure de visibilité, et ne suivez pas ses variations de quelques points.
Page de HubSpot relue le 18 novembre 2026 ; elle nomme l'outil « AI Search Grader », son adresse dit « AEO Grader ». L'AEO, qu'on appelle aussi GEO, désigne le travail pour être cité et recommandé par les moteurs de réponse (définition de l'AEO). Ce guide appartient aux guides pour décider.
L'essentiel en 60 secondes
- Le score additionne cinq composantes publiées par HubSpot : sentiment (40 points), qualité de présence (20), reconnaissance de marque (20), part de voix (10) et position concurrentielle (10).
- Trois modèles sont interrogés en même temps : GPT-5.4 mini, Perplexity et Gemini. HubSpot parle de leurs données d'entraînement et ne dit rien de la recherche web.
- Questions posées, nombre de réponses par modèle, marge d'erreur : rien de cela n'est publié. Un écart de quelques points ne peut donc pas être distingué du hasard.
- Les libellés des composantes relevés par un testeur en juillet 2026 diffèrent de ceux de la page actuelle, pour les mêmes maxima : comparez deux scores avec prudence.
- Ce qui répond à la question « les IA me recommandent-elles ? » : un panel figé de questions d'acheteurs, répété, daté, avec mentions et citations comptées à part.
- Après le score : corrigez les erreurs factuelles, construisez ce panel, puis choisissez entre relevé manuel et outil de suivi.
Que mesure le score du HubSpot AEO Grader ?
En bref
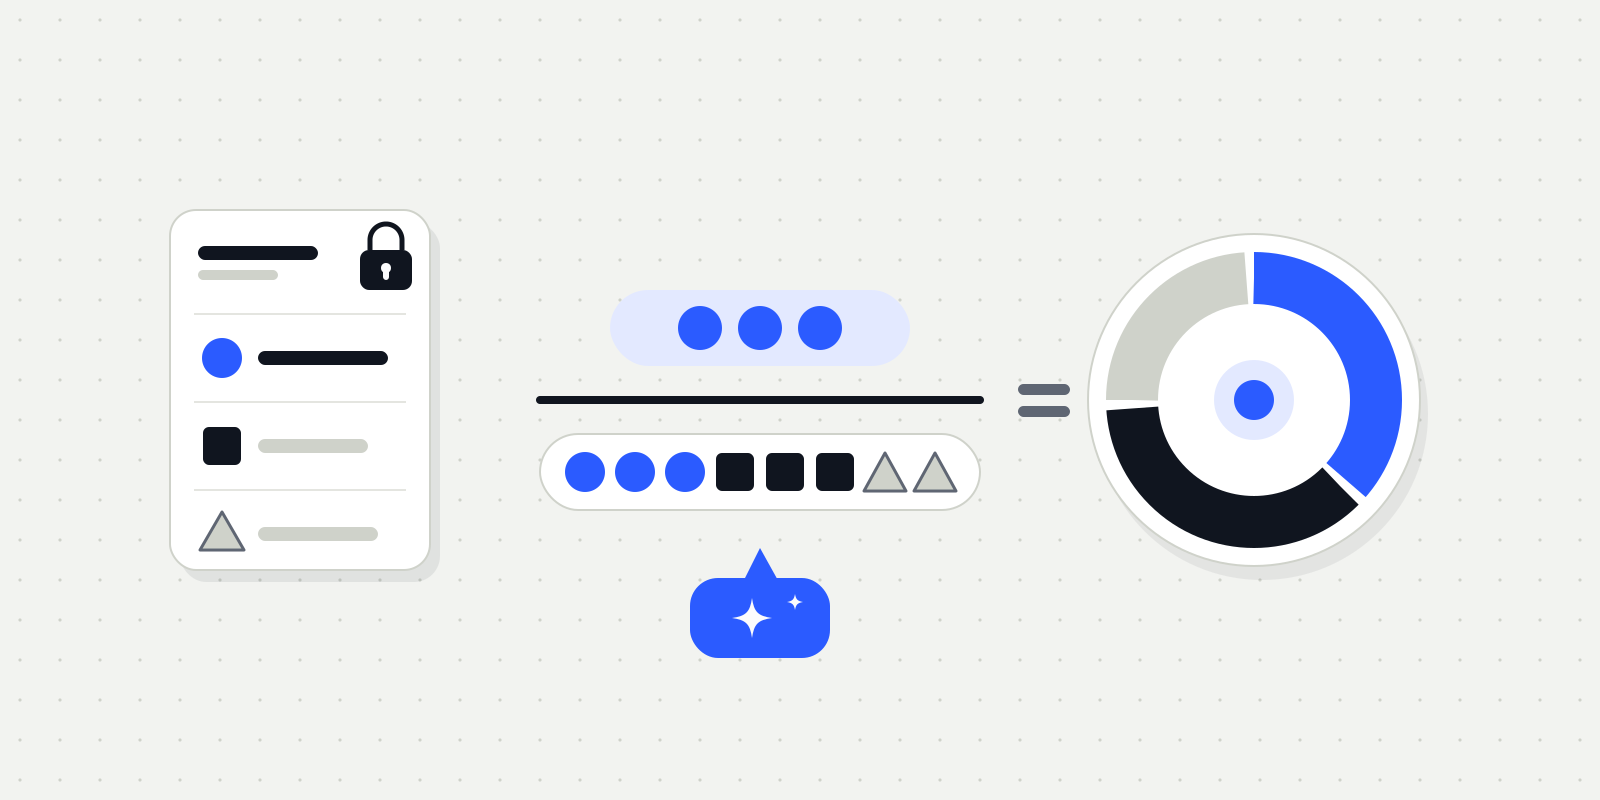
Une perception. Selon la page de HubSpot relue le 18 novembre 2026, l'outil demande à GPT-5.4 mini, Perplexity et Gemini ce qu'ils savent de votre marque d'après leurs données d'entraînement, note le ton, la profondeur et la place face aux concurrents, puis combine cinq composantes en un score sur 100. Il ne dit pas si vous êtes cité ou recommandé quand un acheteur pose sa question.
Vous saisissez le nom de l'entreprise, son lieu, ses produits ou services et son secteur. HubSpot annonce un résultat en moins de deux minutes, sans compte (page de l'outil). Selon le test de Sales Dorado, le rapport détaillé demande une adresse e-mail ; le formulaire n'a pas pu être lu sur la page de HubSpot lors de notre relecture. Un concurrent peut aussi être analysé.
HubSpot distingue ce diagnostic ponctuel de son outil payant, HubSpot AEO, qui suit en continu des questions configurées (prix sur la page officielle, non repris ici).
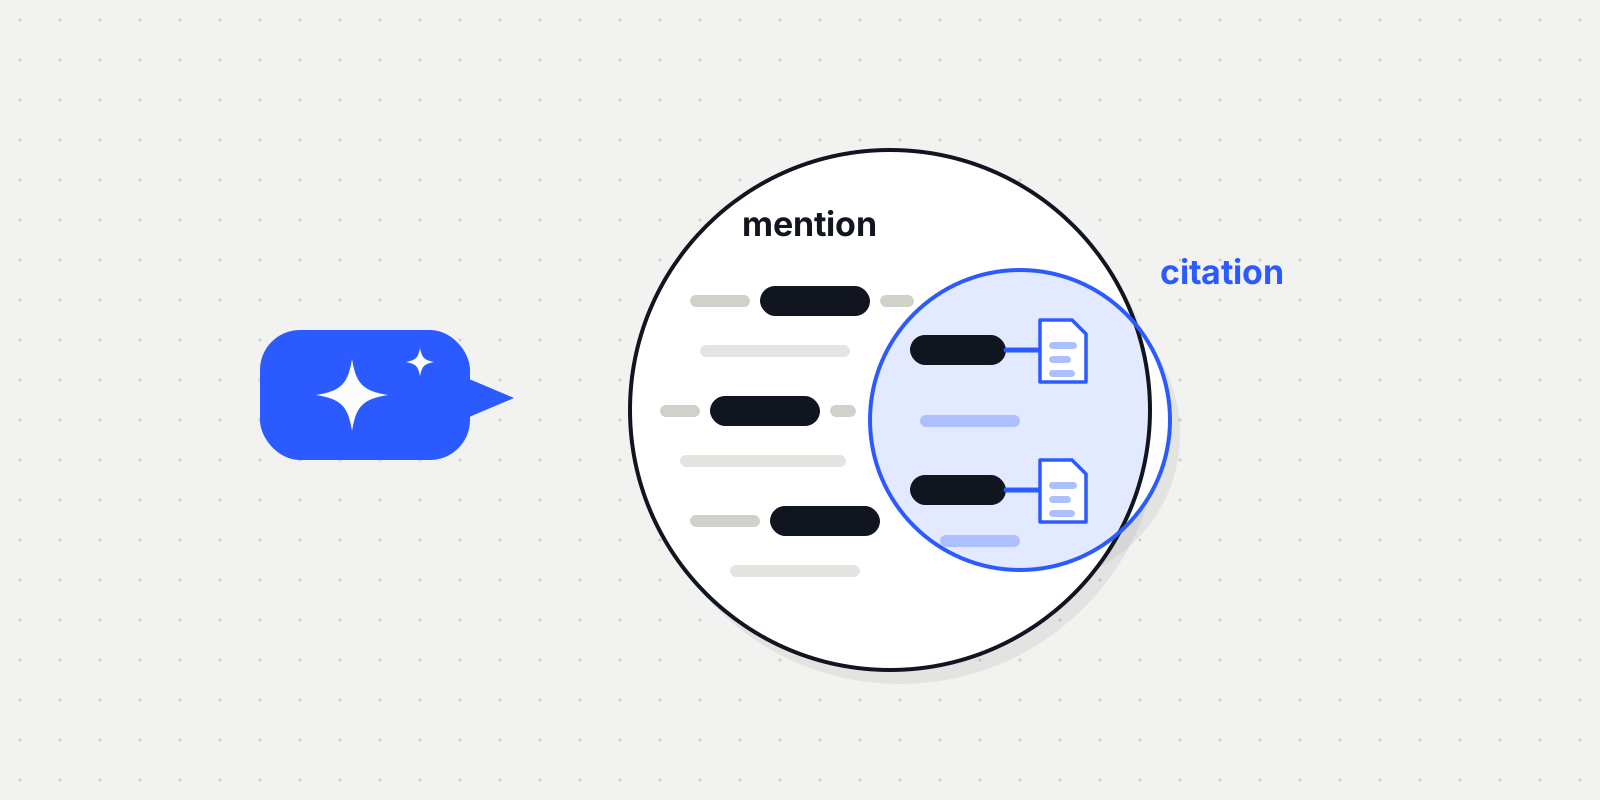
La page ne dit pas si le Grader sépare les trois cas qui comptent : marque mentionnée, recommandée comme choix, ou citée comme source liée (mention, recommandation, citation).
Les cinq composantes et leurs poids : ce que HubSpot documente
En bref
Le sentiment pèse 40 points sur 100, la qualité de présence et la reconnaissance de marque 20 chacune, la part de voix et la position concurrentielle 10 chacune. HubSpot décrit chaque composante en une ou deux phrases, mais ne donne ni la formule de calcul, ni les questions posées, ni le nombre de réponses lues. Lecture de sa page au 18 novembre 2026.
| Composante (libellé HubSpot) | Points | Ce que HubSpot dit mesurer |
|---|---|---|
| Sentiment Results | 40 | Le ton employé par les IA pour décrire la marque : sentiment général, par sujet et usage, et selon la crédibilité des sources qui forment cette description |
| Presence Quality | 20 | La profondeur des mentions, l'autorité des sources derrière ce que l'IA sait de vous, la variété et la complétude des informations disponibles |
| Brand Recognition | 20 | L'étendue de la reconnaissance de la marque dans les données d'entraînement, et la capacité de l'IA à en parler en détail plutôt qu'à la nommer |
| Share of Voice | 10 | Le rang face aux concurrents dans les réponses générées au moment de l'analyse : pourcentage estimé de la catégorie et bonus de rang |
| Market Competition | 10 | Le rôle dans la catégorie (leader, challenger, acteur de niche) et la perception d'innovation |
Source : [HubSpot, AI Search Grader](https://www.hubspot.com/aeo-grader), page sans date de mise à jour (copyright 2026), relue le 18 novembre 2026. Traduction et résumé d'Evocia ; le score combine les cinq composantes et HubSpot écrit le valider sur les trois modèles, sans dire comment, hors une logique de nouvelles tentatives non chiffrée.
Les libellés ont changé. Le test publié par Sales Dorado le 29 juillet 2026 énumère Brand Perception (40), Quality of Presence (20), Brand Awareness (20), Market Position (10) et Brand Exposure (10). Les maxima concordent ; la correspondance des libellés est notre déduction, et nous n'avons trouvé aucun journal des changements de HubSpot.
À retenir
Ne comparez pas un score de l'été à un score d'aujourd'hui comme deux points d'une même courbe : rien ne garantit le même calcul.
Données d'entraînement ou recherche web : pourquoi la différence compte
En bref
Parce que vos acheteurs voient souvent une réponse construite après une recherche sur le web, avec des pages citées, alors que le Grader dit interroger ce que les modèles ont appris. Google documente que ses aperçus IA et son mode IA lancent plusieurs recherches liées et affichent des liens d'appui. Une marque peut être bien connue d'un modèle et absente de ces réponses, ou l'inverse.
Google Search Central décrit des recherches multiples « across subtopics and data sources », des pages d'appui affichées en liens, et des réponses et liens qui varient entre aperçus IA et mode IA. ChatGPT peut lui aussi chercher avant de répondre : le mécanisme est détaillé dans le guide du query fan-out de ChatGPT. La page d'aide d'OpenAI sur sa recherche n'a pas pu être relue le 18 novembre 2026 (accès refusé) : nous ne la citons pas.
Conséquence possible, non mesurée ici : une entreprise récente peut avoir une faible reconnaissance de marque et être citée grâce à une bonne page dès que la réponse s'appuie sur le web ; une marque ancienne peut avoir un bon sentiment et n'être jamais proposée sur une question d'achat.
HubSpot ne dit pas si ses appels à Perplexity et à Gemini passent par la recherche web, ni quelles questions servent à la part de voix, décrite « at the time of your analysis ».
Un instantané : que veut dire un écart de quelques points ?
En bref
Rien de sûr. Sans nombre de répétitions ni marge d'erreur publiés, un score qui gagne ou perd quelques points peut venir du seul hasard des réponses. Dans l'AI Sources Index 2026 d'Evocia (ChatGPT via l'API, 14 septembre 2026), une réponse unique ne fait voir que 58,1 % des couples requête et domaine que quatre répétitions révèlent. Une seule exécution est un échantillon.
Ce chiffre porte sur des domaines cités par ChatGPT, pas sur un score HubSpot : il montre seulement l'ampleur de la variation d'une réponse à l'autre. Le détail est dans combien de fois répéter une question à ChatGPT.
Le test de Sales Dorado en donne un exemple : sur une exécution, la même marque obtient 53 avec OpenAI, 63 avec Perplexity et 67 avec Gemini. Sans questions ni nombre de passages publiés, on n'en conclut rien sur la marque, seulement que les moteurs divergent.
Dans un billet qui présente son outil de suivi, et non le Grader, le blog de HubSpot écrit que les réponses des IA fluctuent plus que les classements classiques et conseille un suivi mensuel sur des questions stables (HubSpot, AI visibility score, mis à jour le 23 octobre 2026). C'est la logique d'un panel figé.
La grille : ce que chaque composante laisse sans réponse, et la mesure qui y répond
En bref
Pour chacune des cinq composantes, la grille met en regard ce que HubSpot documente, ce qui manque pour en faire une mesure, et le relevé qui répond à la question d'un acheteur. Le manque commun : questions, répétitions, marge d'erreur et recherche web. La réponse commune : un panel figé de questions d'acheteurs, posé plusieurs fois par moteur, à date fixe. Grille Evocia du 18 novembre 2026.
| Composante (points) | Documenté par HubSpot | Non documenté | Mesure qui y répond |
|---|---|---|---|
| Sentiment (40) | Ton général, par sujet et usage, selon la crédibilité des sources | Questions posées, échelle de notation, sources retenues, recherche web ou non | Relire les réponses brutes du panel et noter chaque erreur factuelle et chaque jugement, moteur par moteur |
| Qualité de présence (20) | Profondeur des mentions, autorité des sources, richesse des informations | Liste des sources, méthode pour juger leur autorité | Relever les pages réellement citées dans les réponses avec recherche web, en séparant vos pages et les pages tierces |
| Reconnaissance de marque (20) | Reconnaissance dans les données d'entraînement, capacité à parler de la marque en détail | Questions posées, date des connaissances des modèles | Poser des questions directes (« que fait cette entreprise ? ») à chaque moteur, plusieurs fois, et comparer les faits à la réalité |
| Part de voix (10) | Rang face aux concurrents au moment de l'analyse, pourcentage estimé et bonus de rang | Concurrents retenus, questions, nombre de réponses, formule du bonus | Calculer la part de voix sur le panel, dénominateur publié et concurrents nommés (part de voix IA) |
| Position concurrentielle (10) | Rôle dans la catégorie et perception d'innovation | Critères de classement entre leader, challenger et niche | Poser les questions de choix de vos acheteurs et noter si vous êtes recommandé, à quel rang et avec quelle qualification |
| Score global (100) | Combinaison pondérée, validée sur les trois modèles | Formule de validation, répétitions, marge d'erreur, historique des versions | Ne suivre que des indicateurs à dénominateur connu : taux de mention, de recommandation et de citation par moteur sur le même panel |
Grille Evocia du 18 novembre 2026. Colonnes 2 et 3 : [page de HubSpot](https://www.hubspot.com/aeo-grader) relue ce jour ; « non documenté » veut dire que la page ne le dit pas, pas que l'outil ne le fait pas. Colonne 4 : recommandation d'Evocia, applicable à tout score de visibilité IA, y compris aux mesures d'Evocia.
Que faire après avoir obtenu votre score ?
En bref
Trois gestes, dans cet ordre. Corrigez ce que le rapport révèle d'inexact sur votre marque, car c'est son apport le plus fiable. Construisez ensuite une vingtaine de questions d'acheteurs, figées et datées, à poser plusieurs fois à chaque moteur. Choisissez enfin entre un relevé manuel et un outil de suivi, d'après les assistants, le pays et l'accès aux réponses brutes.
- 1Lisez le texte, pas le chiffre. Notez chaque phrase fausse ou datée du rapport (offre, cible, prix, rachat, nom) et corrigez-la à la source : votre site, vos fiches, les pages tierces qui parlent de vous.
- 2Regardez qui est rangé devant vous. Vérifiez ensuite, sur vos propres questions, si les IA recommandent vraiment ces concurrents à votre place.
- 3Figez un panel. Une vingtaine de questions formulées comme vos acheteurs, posées chacune plusieurs fois à ChatGPT, Gemini et Perplexity, à la même date chaque mois. Comptez à part mentions, recommandations et citations.
- 4N'annoncez pas une hausse de quelques points. Sans marge d'erreur, elle ne prouve rien ; une hausse du taux de recommandation sur le même panel, si.
Pour l'étape suivante, la comparaison des outils de suivi payants sur huit critères (assistants, France, répétitions, réponses brutes) est dans Otterly, Semrush, Ahrefs Brand Radar ou Qwairy : quel outil choisir. HubSpot AEO n'y figure pas : appliquez-lui les mêmes critères. Les autres scores gratuits, qui lisent souvent votre site au lieu d'interroger les IA, sont comparés dans audit GEO/AEO gratuit ou payant.
Le Grader vous dit ce que les modèles pensent de vous ; reste à savoir qui ils recommandent quand vos acheteurs cherchent. Le test de visibilité IA d'Evocia pose trois questions de votre catégorie, plusieurs fois, à ChatGPT et à une ou deux autres IA, et vous dit qui est cité à votre place.
Tester ma visibilité IALimites de ce guide
En bref
Ce guide décrit ce que HubSpot publie au 18 novembre 2026 ; l'outil a déjà changé ses libellés depuis l'été et peut changer encore. Nous n'avons pas testé l'outil ni comparé ses scores à des citations relevées, et personne ne l'a publié à notre connaissance. L'unique test tiers ouvert porte sur une seule marque et une seule exécution.
- Origine du terme. Le GEO vient d'une étude universitaire de 2023 (Aggarwal et al., arXiv 2311.09735) qui ne traite pas des scores de perception : elle ne valide ni n'invalide le Grader.
Questions fréquentes
Qu'est-ce que le HubSpot AEO Grader ?
Un outil gratuit de HubSpot, nommé AI Search Grader sur sa page : il interroge trois modèles sur votre marque et rend un score sur 100. C'est un diagnostic ponctuel, distinct du suivi payant HubSpot AEO.
Que signifie le score d'un AEO grader (aeo grader meaning) ?
Il résume la façon dont des modèles d'IA décrivent votre marque : ton, profondeur, reconnaissance, rang face aux concurrents. Il ne compte pas combien de fois vous êtes cité ou recommandé sur les questions de vos acheteurs.
Le HubSpot AEO Grader est-il gratuit ?
Oui selon HubSpot, sans compte. Selon le test de Sales Dorado, le rapport détaillé demande une adresse e-mail. Le suivi continu, HubSpot AEO, est payant ; son prix est sur la page officielle de HubSpot.
Que contient le rapport du HubSpot AEO Grader (aeo grader report) ?
D'après le test publié par Sales Dorado en juillet 2026, l'aperçu affiché à l'écran, sans e-mail, donne un score par moteur. Le rapport détaillé, qui demande une adresse e-mail, en dit davantage : Sales Dorado y relève les décomptes de mentions, la part de marché, les niveaux de confiance, l'analyse des sources, les thèmes et la polarisation.
Le score du HubSpot AEO Grader est-il fiable pour savoir si ChatGPT recommande mon entreprise ?
Non : il s'appuie sur ce que les modèles ont appris, sans questions ni répétitions publiées. Pour le savoir, posez vos questions d'acheteurs à ChatGPT plusieurs fois et notez qui il recommande.
Sources
- HubSpot, AI Search Grader (page de l'outil : cinq composantes et poids, modèles interrogés, données d'entraînement, instantané, champs de saisie), sans date de mise à jour, consultée le 18 novembre 2026
- HubSpot, AI visibility score (blog, sur l'outil de suivi HubSpot AEO), mis à jour le 23 octobre 2026, consulté le 18 novembre 2026
- Sales Dorado, test du HubSpot AEO Grader sur une marque française, publié le 29 juillet 2026, consulté le 18 novembre 2026
- Google Search Central, AI features and your website, consultée le 18 novembre 2026
- Aggarwal et al., GEO: Generative Engine Optimization, arXiv 2311.09735 (v1 du 16 novembre 2023, v3 du 28 juin 2024)
Transparence et méthode
Auteur
Evocia · Cabinet français de visibilité dans les IA
Evocia est une équipe française de croissance SEO, GEO et AEO : elle mesure et améliore la visibilité des entreprises sur Google et dans les réponses des IA. Elle vend un suivi des réponses, ce qui la place en concurrence partielle avec l'outil payant de HubSpot : la grille de ce guide s'applique aussi à ses propres mesures.
Comment cet article a été réalisé
- Pages relues le 18 novembre 2026 : page de l'outil sur hubspot.com, billet du blog de HubSpot sur le score de visibilité IA, test de Sales Dorado, page de Google Search Central sur les fonctionnalités d'IA. La page d'aide d'OpenAI sur la recherche de ChatGPT a répondu par un refus d'accès (403) : elle n'est ni relue ni citée.
- Aucun essai de l'outil : aucun compte créé, aucune coordonnée saisie (selon Sales Dorado, le rapport détaillé demande un e-mail). Le score d'evocia.fr n'a donc pas été relevé, la grille ne repose sur aucun essai, et aucun score de marque tierce n'est repris comme mesure ; les chiffres de Sales Dorado illustrent une exécution unique.
- Grille : composantes et descriptions reprises de la page de HubSpot ; « non documenté » signifie absent de cette page à cette date. La colonne « mesure qui y répond » est une recommandation d'Evocia, fixée avant la rédaction et appliquée à toutes les lignes.
- Chiffre de variabilité lu dans lib/chiffres-etude.ts (AI Sources Index 2026, 870 couples requête et domaine, ChatGPT via l'API avec recherche web, collecte du 14 septembre 2026), sans nouveau calcul ni extrapolation aux scores de HubSpot ou aux autres moteurs.
Historique des mises à jour
- 18 novembre 2026Publication initiale : ce que mesure le score du HubSpot AEO Grader (AI Search Grader), ses cinq composantes et leurs poids lus à la source, changement de libellés depuis juillet 2026, différence entre données d'entraînement et réponses avec recherche web, portée d'un instantané, grille de ce que chaque composante laisse sans réponse et de la mesure qui y répond, que faire après le score, limites.