Skill Claude pour le GEO et l'AEO : ce que mesure son score, et ce qu'il ne mesure pas
Un skill Claude d'audit GEO vous dit si votre site est lisible par les robots des IA, pas si ChatGPT ou Perplexity vous citent. Les deux projets lus pour ce guide, geo-seo-claude et claude-seo, analysent vos pages et en tirent une note. D'après leur documentation, leur score ne repose pas sur les réponses des IA, et aucune validation publiée ne le relie à des citations.
Notre position : servez-vous-en comme d'une liste de contrôle technique gratuite, jamais comme d'une mesure de visibilité. Un score qui monte prouve que vous avez suivi la grille de son auteur, rien de plus.
Sources relues le 14 novembre 2026. Le GEO, qu'on appelle aussi AEO (optimisation pour les moteurs de réponse), désigne le travail pour être cité et recommandé par les assistants IA. Ce guide appartient aux guides pour décider.
L'essentiel en 60 secondes
- Un skill est un dossier d'instructions et de scripts que Claude charge à la demande ; dans Claude Code, ses scripts ont le même accès réseau que tout programme de votre poste.
- Les deux skills publient des poids dans leurs fichiers SKILL.md : six familles pour geo-seo-claude (25, 20, 20, 15, 10 et 10 %), cinq pour claude-seo (25, 20, 15, 20 et 20 %). Seul claude-seo les dit heuristiques.
- L'accès des robots et l'indexation sont documentés par les éditeurs de moteurs ; la longueur idéale des passages, le poids des mentions de marque et le llms.txt ne le sont pas.
- Un score fixe ne peut pas décrire un résultat qui varie : les sources que cite ChatGPT changent d'une répétition à l'autre de la même requête (AI Sources Index 2026).
- Avant de vous fier à un score GEO automatique, posez six questions : IA interrogées, origine des poids, validation, sources des seuils, évaluation par un tiers, code relu.
- Pour savoir si les IA vous citent, il faut relever leurs réponses, à la main ou avec un outil de suivi.
Qu'est-ce qu'un skill Claude pour le GEO, et que vérifie-t-il ?
En bref
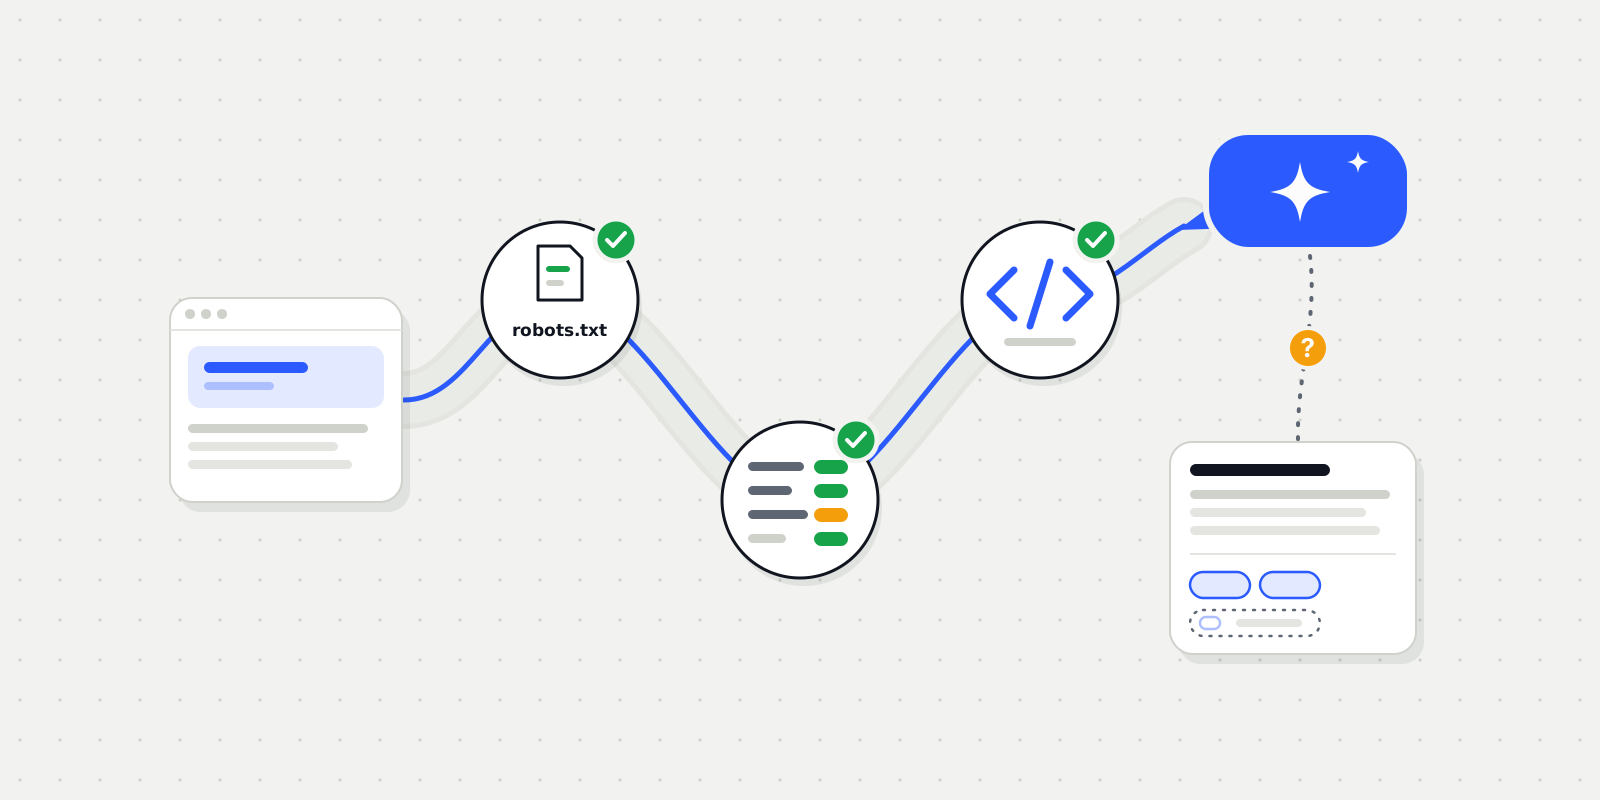
Un skill est un dossier qui contient un fichier SKILL.md et, souvent, des scripts que Claude exécute quand votre demande correspond à sa description. Les skills GEO open source lisent vos pages, contrôlent l'accès des robots, le llms.txt, les données structurées, le contenu et la présence de votre marque, puis rendent une note et des recommandations. Ils observent votre site, pas les réponses des IA.
La documentation d'Anthropic sur les Agent Skills décrit un chargement par étapes : le nom et la description du skill en permanence, les instructions quand il se déclenche, les fichiers et scripts au besoin. Dans Claude Code, ses scripts ont « le même accès réseau que tout autre programme » de votre ordinateur.
Concrètement, vous lancez la commande d'audit avec votre adresse ; Claude lit vos pages, exécute les scripts et rédige un rapport, comme un robot d'audit SEO orienté vers les assistants IA.
geo-seo-claude et claude-seo : ce que disent leurs README et leurs SKILL.md
En bref
Les deux projets sont publiés sous licence MIT et publient les poids de leur score. geo-seo-claude annonce cinq sous-agents et un score GEO en six familles ; claude-seo annonce 26 sous-skills, 19 sous-agents et une commande /seo geo qui rend un « GEO Readiness Score » sur 100 en cinq catégories. Aucun des deux scores ne repose sur les réponses des IA. Lu le 14 novembre 2026.
| Point lu (README et SKILL.md) | geo-seo-claude | claude-seo |
|---|---|---|
| Licence | MIT | MIT |
| Composants annoncés | Cinq sous-agents ; 13 sous-skills annoncés, 14 dossiers listés | 26 sous-skills, 19 sous-agents |
| Score GEO | Pondéré en six familles (geo-audit), poids publiés, origine des poids non indiquée | « GEO Readiness Score » sur 100, cinq catégories pondérées (seo-geo : 25, 20, 15, 20, 20 %), décrit comme « heuristique » et « pas un modèle mesuré », à ne jamais présenter comme un taux de citation prédit |
| Contrôles GEO décrits | Citabilité, mentions de marque, E-E-A-T, technique (robots IA, llms.txt), données structurées, préparation par plateforme | Citabilité, lisibilité structurelle, multimédia, autorité et marque, accès technique (robots IA ; llms.txt signalé mais sans poids) |
| Interrogation des IA | Non décrite dans geo-audit | Pas dans le score ; avec un outil tiers installé (DataForSEO, SE Ranking), des scores par plateforme ne sont donnés que pour ce qu'il mesure, sinon « non mesuré » ; extensions optionnelles (Profound, SE Ranking) avec votre propre compte, méthode non précisée |
| Validation du score contre des citations réelles | Aucune publiée | Aucune publiée ; résultats Search Console du projet déclarés par l'auteur |
README et fichiers SKILL.md lus le 14 novembre 2026 : [README de geo-seo-claude](https://github.com/zubair-trabzada/geo-seo-claude) et [SKILL.md de ses skills](https://github.com/zubair-trabzada/geo-seo-claude/tree/main/skills) (geo-audit, geo-citability, geo-brand-mentions) ; [README de claude-seo](https://github.com/AgriciDaniel/claude-seo) et [SKILL.md de seo-geo](https://github.com/AgriciDaniel/claude-seo/blob/main/skills/seo-geo/SKILL.md). Ce que les projets disent faire, sans exécution de leur code ni note de qualité.
Le registre tiers tessl affiche pour le skill geo-audit de geo-seo-claude « This skill can't be scored yet » : des erreurs de validation non détaillées bloquent ses notes (registre tessl, geo-audit, 14 novembre 2026). Cela ne dit rien de la justesse de l'audit.
La grille : quel niveau de preuve pour chaque contrôle ?
En bref
Sur les six familles du score de geo-seo-claude, deux s'appuient en partie sur une documentation d'éditeur de moteur : la famille technique (accès des robots, indexation) et, pour Google seulement, le contenu. La citabilité a un appui expérimental partiel (ajout de sources, de citations et de statistiques), l'autorité de marque une corrélation observée par un tiers. La longueur idéale des passages, le llms.txt, l'effet des données structurées et l'optimisation par plateforme ne sont pas établis. Aucun poids n'a de source.
| Famille (poids dans geo-seo-claude) | Ce que le skill contrôle | Ce qui est documenté ou observé | Niveau de preuve |
|---|---|---|---|
| Citabilité IA (25 %) | Passages « citables » de 134 à 167 mots, autonomes, riches en faits | Ajout de sources, de citations et de statistiques : étude arXiv ci-dessous, qui ne teste ni la longueur ni l'autonomie des passages. Le skill attribue le seuil de 134-167 mots à « Bortolato 2025 » (sans lien, non ouvert par nous) et à l'étude arXiv, où il n'apparaît pas. claude-seo donne « 130 à 170 mots » comme heuristique de lisibilité | Mixte : ajout de sources, citations et statistiques soutenu par une étude ; passages autonomes et longueur non établis |
| Autorité de marque (20 %) | Mentions de marque par des tiers ; le skill affirme une corrélation « 3x » plus forte que les liens, qu'il attribue à une étude Ahrefs sur 75 000 marques (« décembre 2025 ») | AI Sources Index : Reddit consulté par ChatGPT dans 100 réponses et cité dans 0, Wikipedia consulté dans 85 et cité dans 0 (ChatGPT cite-t-il Reddit). L'étude Ahrefs ouverte (page datée du 26 mai 2025, modifiée en avril 2026) porte sur les aperçus IA de Google : corrélation de Spearman de 0,664 pour les mentions web de marque contre 0,218 pour les backlinks, soit un rapport d'environ 3, présenté par Ahrefs comme une corrélation, pas une cause (étude Ahrefs). Aucun éditeur ne documente le poids des mentions | Corrélation observée par un tiers (aperçus IA de Google) ; causalité et poids non établis ; observation Evocia limitée à ChatGPT et aux sources citées |
| Contenu et E-E-A-T (20 %) | Expertise, lisibilité, fraîcheur | Google : « les bonnes pratiques SEO restent pertinentes » pour ses fonctionnalités d'IA. Rien de publié par les autres éditeurs | Documenté pour Google, en général ; poids non établi |
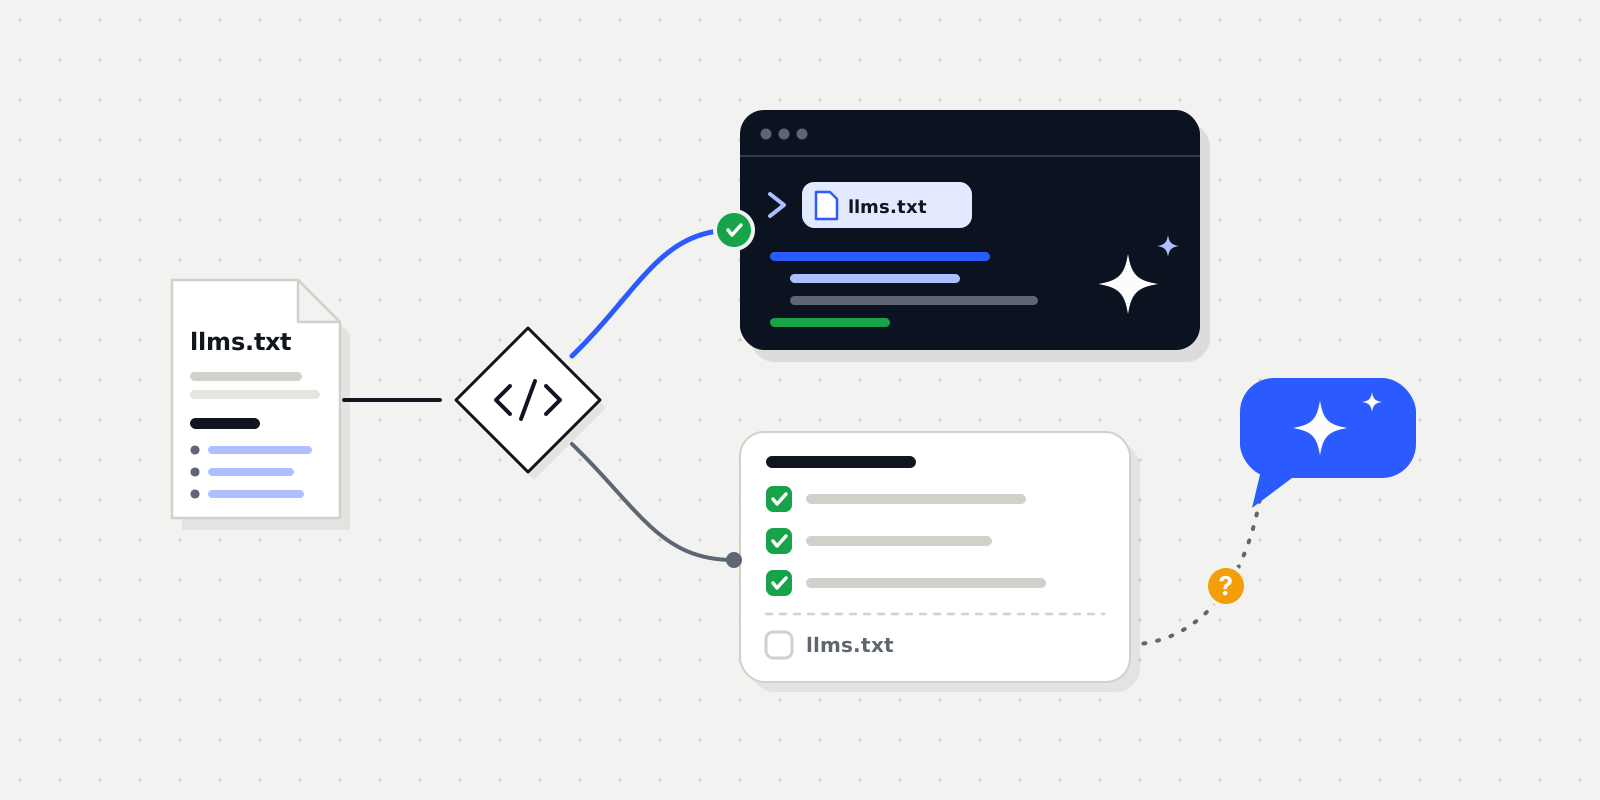
| Technical GEO (15 %) | Accès des robots IA dans robots.txt, llms.txt, rendu, vitesse (geo-audit rattache robots et llms.txt à cette famille, pas à la citabilité) | Robots : OpenAI, Anthropic et Perplexity documentent les leurs (vérifier si les IA lisent votre site). Google : page indexée et éligible à un extrait, « aucune exigence technique supplémentaire ». llms.txt : aucun grand éditeur ne documente le lire ; claude-seo le signale sans poids (guide du llms.txt) | Robots et indexation documentés ; rendu et vitesse non établis pour les IA ; llms.txt non établi |
| Données structurées (10 %) | Détection, validation et génération de données structurées | Google : aucune donnée structurée schema.org spéciale à ajouter. Aucun effet démontré ailleurs (données structurées et IA) | Non requis selon Google ; effet non établi ailleurs |
| Optimisation par plateforme (10 %) | Préparation pour ChatGPT, Perplexity et les aperçus IA de Google | Aucun éditeur ne publie de critères propres à son assistant | Non établi |
Grille Evocia du 14 novembre 2026. « Documenté » : écrit par l'éditeur du moteur. « Observé » : AI Sources Index 2026 d'Evocia, ChatGPT via l'API, 14 septembre 2026, sans extrapolation. « Non établi » : aucune source d'éditeur ni étude trouvée, ce qui ne prouve pas l'inutilité du contrôle.
La phrase de Google est nette : « There are no additional requirements to appear in AI Overviews or AI Mode, nor other special optimizations necessary » (Google Search Central). Elle ne vaut que pour la recherche Google : elle ne dit rien de ChatGPT, Claude ou Perplexity.
L'appui expérimental vient de l'étude qui a lancé le terme (Aggarwal et al., arXiv 2311.09735, 2023, révisée en 2024). Sur un moteur expérimental bâti sur gpt-3.5-turbo, citer des sources, ajouter des citations ou des statistiques améliore la visibilité relative de 30 à 40 % sur sa mesure principale (« jusqu'à 40 % » dans le résumé). Le gain de 115,1 % ne concerne que les sites classés cinquièmes, avec l'ajout de sources. Aucun de ces chiffres ne valide un score : geo-audit écrit que les sites au score élevé « voient 30 à 115 % de visibilité en plus » en citant cette étude, mais celle-ci teste des modifications de contenu, pas un score de site.
Le score GEO d'un audit automatique dit-il si les IA vous citent ?
En bref
Non. Le score décrit votre site à un instant donné ; la citation dépend de la question posée et varie d'un essai à l'autre. Dans l'AI Sources Index 2026 d'Evocia (ChatGPT via l'API, 14 septembre 2026), 38 % des couples requête et domaine n'apparaissent que dans une seule des quatre répétitions de la requête, et seules 23 sur 165 requêtes citent exactement les mêmes domaines à chaque répétition.
Deux sites de même note peuvent avoir des sorts opposés : l'un est cité sur les questions de ses acheteurs, l'autre jamais, parce que les IA lui préfèrent ses concurrents ou une page tierce. Le score ne voit ni la question, ni les concurrents. Le détail de la variabilité est dans ChatGPT donne-t-il les mêmes sources.
À retenir
Et donc : présentez un score de site comme une liste de contrôles passés ou non, jamais comme un indicateur de visibilité.
Six questions avant de se fier à un score GEO automatique
En bref
Demandez si l'outil interroge les IA, d'où viennent ses poids, si son score a été confronté à des citations réelles, si ses seuils ont une source, si un tiers l'a évalué et ce que fait son code sur votre poste. Au 14 novembre 2026, geo-seo-claude ne décrit pas d'interrogation des IA, ne justifie pas ses poids, ne publie pas de validation et ne source qu'une partie de ses chiffres ; claude-seo est plus prudent (scores de plateforme seulement s'ils sont mesurés) mais ne publie ni validation ni source pour tous ses seuils.
| Question | Réponse qui rassure | geo-seo-claude | claude-seo |
|---|---|---|---|
| 1. Interroge-t-il les IA sur les questions de vos acheteurs ? | Oui, questions choisies avec vous, répétées, moteur par moteur | Non décrit | Non par défaut ; outil tiers optionnel |
| 2. D'où viennent les poids du score ? | Une formule publiée et justifiée | Publiés, non justifiés | Publiés, présentés comme heuristique |
| 3. Le score a-t-il été confronté à des citations réelles ? | Une validation publiée, avec méthode | Aucune publiée | Aucune publiée |
| 4. Les seuils et chiffres cités ont-ils une source ? | Chaque seuil renvoie à un éditeur ou une étude | Partiellement : « 3x » renvoie à une étude Ahrefs (corrélation) ; « 134 à 167 mots » et « 30-115 % » mal appuyés (voir la grille) | Partiellement : « 130-170 mots » donné comme heuristique ; « 44 % des citations dans les 30 premiers % de la page » attribué à SE Ranking |
| 5. Un tiers l'a-t-il évalué ? | Une évaluation indépendante consultable | tessl : « can't be scored yet » | Indisponible (non trouvé) |
| 6. Savez-vous ce que fait le code sur votre poste ? | Vous avez relu SKILL.md et les scripts | À relire vous-même | À relire vous-même |
Liste de contrôle Evocia du 14 novembre 2026, applicable à tout score GEO ou AEO automatique, y compris à un outil d'Evocia. Colonnes de droite : ce que disent les README et SKILL.md à cette date, pas un test des outils.
La sixième question n'est pas théorique. Anthropic conseille de n'utiliser que des skills de sources de confiance et, sinon, d'en auditer tous les fichiers : un skill malveillant peut conduire à une fuite de données, et un contenu récupéré en ligne peut contenir des instructions malveillantes.
À quoi bon l'utiliser, et quand passer à une mesure des réponses ?
En bref
Utilisez un skill GEO pour repérer en quelques minutes un robot bloqué, une page non indexable ou un balisage cassé : ce sont des causes d'absence totale, documentées par les éditeurs. Passez à une mesure des réponses dès que la question devient « qui les IA recommandent-elles à ma place ? » : seul un relevé répété des réponses y répond.
- 1Traitez d'abord les lignes documentées de la grille : robots de recherche autorisés, pages indexées et éligibles à un extrait.
- 2Traitez les lignes non établies comme des hypothèses, pas comme des corrections obligatoires.
- 3Ignorez la note globale : suivez la liste des contrôles échoués.
- 4Relevez enfin ce que répondent les IA sur une vingtaine de questions d'acheteurs, plusieurs fois chacune, et notez qui est cité à votre place.
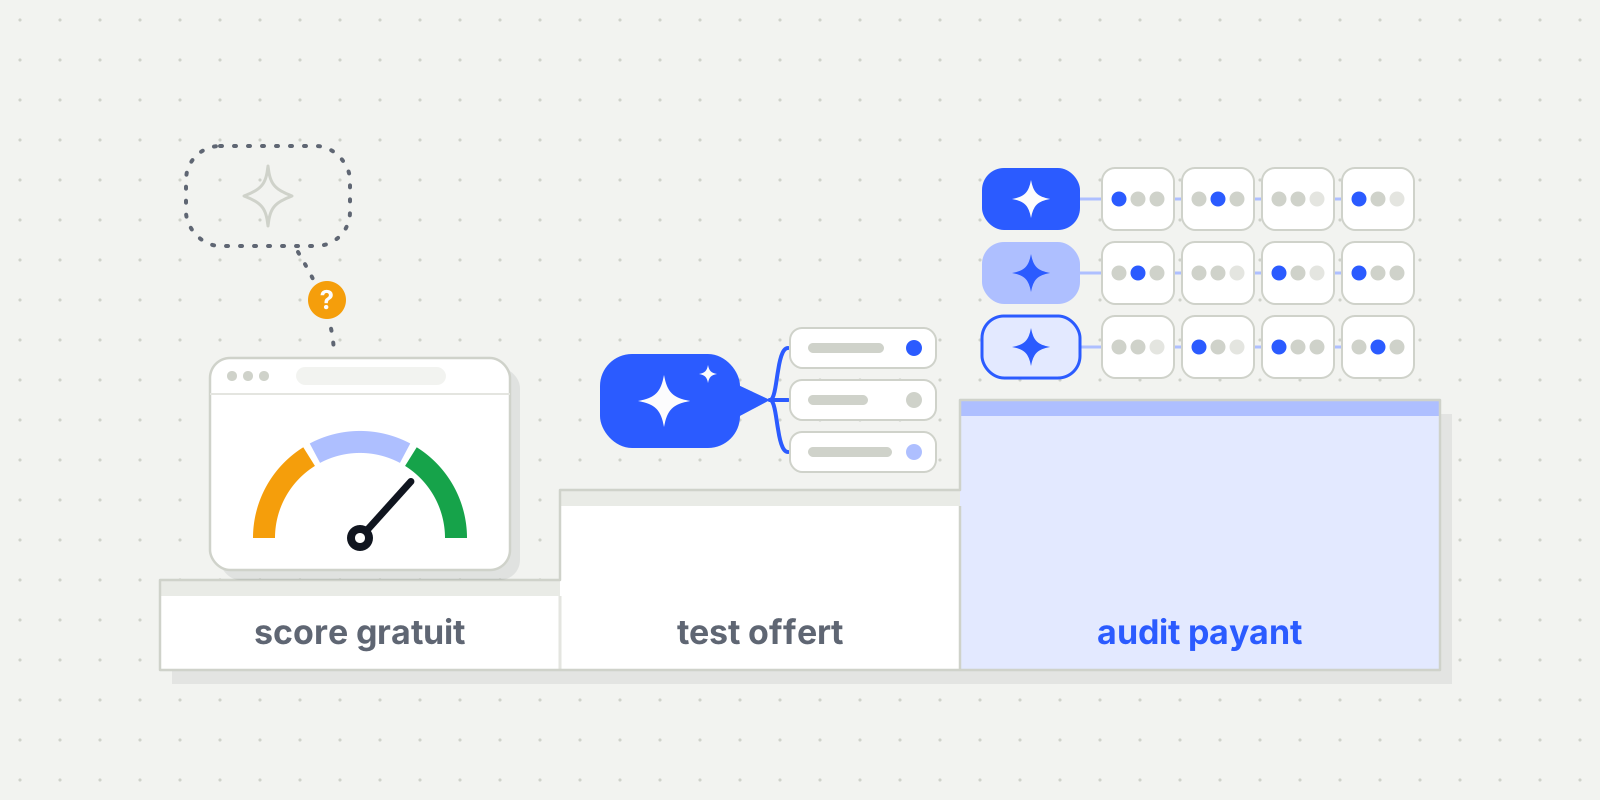
Pour cette dernière étape, le choix entre relevé manuel et outil de suivi est dans outils de mesure de visibilité IA : comment choisir. La différence entre un score gratuit, un test offert et un audit payant est dans audit GEO/AEO gratuit ou payant, et la conduite complète d'un audit dans comment auditer sa visibilité dans les IA.
Votre skill dit que le site est prêt ; reste à savoir ce que les IA répondent. Le test de visibilité IA d'Evocia pose trois questions de votre catégorie, plusieurs fois, à ChatGPT et à une ou deux autres IA, et vous dit qui est cité à votre place.
Tester ma visibilité IALimites de ce guide
En bref
Ce guide décrit ce que les deux projets disent faire dans leurs README et SKILL.md au 14 novembre 2026 : leur code n'a pas été exécuté, et ces documentations changent vite. La grille juge le niveau de preuve des contrôles, pas leur utilité réelle, qu'aucune étude publiée ne mesure. Les observations d'Evocia portent sur ChatGPT seul.
- Pas de test. Nous n'avons comparé aucun score à des citations ; personne ne l'a publié non plus, à notre connaissance.
- Deux projets seulement. D'autres skills GEO existent ; les six questions s'appliquent à tous.
Questions fréquentes
geo seo claude skill : de quoi s'agit-il, et où le trouver sur GitHub ?
D'un dossier d'instructions et de scripts qui ajoute à Claude Code des commandes d'audit SEO et GEO. geo-seo-claude et claude-seo sont publiés sur GitHub sous licence MIT. Relisez leurs fichiers avant de les installer.
Un skill Claude peut-il auditer ma visibilité dans ChatGPT et Perplexity ?
Il audite votre site, pas votre visibilité : par défaut, aucun des deux projets lus ne pose vos questions d'acheteurs à ChatGPT ou Perplexity. Pour la visibilité, il faut relever leurs réponses.
Le score GEO d'un audit automatique prédit-il si les IA vont citer mon site ?
Rien ne l'établit au 14 novembre 2026 : aucun des deux projets ne publie de validation de son score contre des citations réelles. Un bon score retire des obstacles techniques, il ne prédit pas de citation.
Quelles fonctionnalités rechercher dans un outil de generative engine optimization ?
Des questions d'acheteurs posées aux IA et répétées, un résultat par moteur, les réponses brutes consultables, une formule publiée pour tout score et le nom des concurrents cités. Un audit de site en complément, pour l'accès des robots et l'indexation.
Sources
- Anthropic, Agent Skills, documentation Claude (chargement par étapes, accès réseau dans Claude Code, sécurité), consultée le 14 novembre 2026
- geo-seo-claude, README du dépôt GitHub (licence MIT, score pondéré en six familles), consulté le 14 novembre 2026
- claude-seo, README du dépôt GitHub (licence MIT, commande /seo geo, extensions optionnelles), consulté le 14 novembre 2026
- geo-seo-claude, fichiers skills geo-audit, geo-citability et geo-brand-mentions (SKILL.md : poids, seuils, attributions), consultés le 14 novembre 2026
- claude-seo, skills/seo-geo/SKILL.md (poids présentés comme heuristique, llms.txt sans poids), consulté le 14 novembre 2026
- Ahrefs, An Analysis of AI Overview Brand Visibility Factors (75K brands), page publiée le 26 mai 2025, modifiée le 27 avril 2026, consultée le 14 novembre 2026
- Registre tessl, skill geo-audit (« This skill can't be scored yet »), consulté le 14 novembre 2026
- Google Search Central, AI features and your website, consultée le 14 novembre 2026
- Aggarwal et al., GEO: Generative Engine Optimization, arXiv 2311.09735 (v1 du 16 novembre 2023, v3 du 28 juin 2024)
Transparence et méthode
Auteur
Evocia · Cabinet français de visibilité dans les IA
Evocia est une équipe française de croissance SEO, GEO et AEO : elle mesure et améliore la visibilité des entreprises sur Google et dans les réponses des IA. Elle vend un suivi des réponses, ce qui la place en concurrence partielle avec les outils décrits ici : les six questions de ce guide s'appliquent aussi à elle.
Comment cet article a été réalisé
- Pages lues le 14 novembre 2026 : celles de la liste des sources (branche main pour les dépôts GitHub), dont le texte intégral de l'étude arXiv 2311.09735.
- Aucun code tiers n'a été exécuté : les contrôles et les pondérations sont ceux que les auteurs publient. Le « décembre 2025 » cité par le skill n'a pas été retrouvé : la page Ahrefs ouverte est datée de mai 2025. Le README de geo-seo-claude annonce 13 sous-skills et liste 14 dossiers ; la date de son dernier commit n'était pas affichée (indisponible).
- Grille : trois niveaux fixés avant la rédaction. « Documenté » exige une page de l'éditeur du moteur ; « observé » renvoie aux données publiées d'Evocia ; « non établi » signifie qu'aucune source d'éditeur ni étude publiée n'a été trouvée. Une ligne qui mélange plusieurs contrôles reçoit un niveau par contrôle.
- Chiffres d'Evocia lus dans lib/chiffres-etude.ts (AI Sources Index 2026, 870 couples requête et domaine, ChatGPT via l'API avec recherche web, collecte du 14 septembre 2026), sans nouveau calcul ni extrapolation aux autres moteurs.
Historique des mises à jour
- 15 novembre 2026Publication initiale : ce qu'est un skill Claude d'audit GEO, ce que disent les README et SKILL.md de geo-seo-claude et de claude-seo, grille du niveau de preuve des six familles de contrôles, pourquoi un score de site ne dit pas si les IA vous citent, six questions avant de se fier à un score, usage conseillé et passage à la mesure des réponses, limites.