ChatGPT donne de fausses informations sur votre entreprise : d'où elles viennent, ce qui les corrige
Une fausse information de ChatGPT sur votre entreprise a deux origines possibles, et une seule se corrige à la source : une page reprise lors d'une recherche web, ou ce que le modèle a retenu de son entraînement. Ne demandez donc aucune correction avant d'avoir établi l'origine. Dans le premier cas, l'erreur a une adresse, celle d'une page périmée, mal comprise ou consacrée à une autre entreprise ; dans le second, il n'y a aucune source à corriger, et aucune page publiée aujourd'hui ne défera cette phrase.
Un test de quelques minutes sépare les deux, parce qu'ils ne laissent pas la même trace : sur ChatGPT, une réponse qui n'affiche aucune source oriente vers la mémoire du modèle, une réponse qui en affiche oriente vers une page, à vérifier. Viennent ensuite le protocole qui confirme l'erreur avant d'agir, ce qui a un effet sur chaque type d'erreur, et ce qui peut être promis à une direction.
Ce guide traite l'exactitude de ce qui est dit de vous. Si votre problème est de ne pas apparaître du tout, les causes sont inventoriées dans pourquoi ChatGPT recommande vos concurrents et pas vous ; la méthode d'ensemble est dans comment apparaître dans les réponses de ChatGPT. Et si vous n'avez pas encore relevé ce que ChatGPT dit de vous, commencez par là : la grille de relevé des questions qui nomment votre entreprise.
L'essentiel en 60 secondes
- Deux erreurs distinctes produisent le même symptôme : une erreur de récupération (le moteur a repris une page fausse ou périmée) et une erreur de connaissance apprise (il répond de mémoire, sans source).
- Le test qui les sépare tient à une mesure : sur les 147 réponses sans recherche web de l'AI Sources Index 2026, 0 citation ; sur les 853 avec recherche, au moins une chacune. Des sources affichées orientent vers une erreur de récupération, à vérifier dans les pages citées ; leur absence vers une erreur de mémoire.
- Une occurrence ne prouve rien : 38 % des couples requête et domaine de l'étude n'apparaissent qu'une seule fois sur quatre répétitions, et la similarité moyenne des sources entre deux répétitions de la même requête est de 0,55. Confirmez l'erreur avant d'agir.
- Sur une erreur de récupération, le travail est traçable : remonter à la page citée, corriger ce qui vient de chez vous, demander la correction aux tiers, et publier la bonne information à un endroit que le moteur peut atteindre.
- Sur une erreur de connaissance apprise, publier ne défait pas la phrase : la seule voie documentée par OpenAI est une demande de correction pour les informations inexactes concernant une personne, et sa politique précise que la correction n'est pas possible dans tous les cas.
- Ce qui est honnête de promettre : un relevé daté, une origine établie pour chaque erreur, des corrections vérifiables à la source, puis un nouveau relevé dans les mêmes conditions. Ni un délai, ni une correction garantie.
Deux erreurs différentes : récupération web et connaissance apprise
En bref
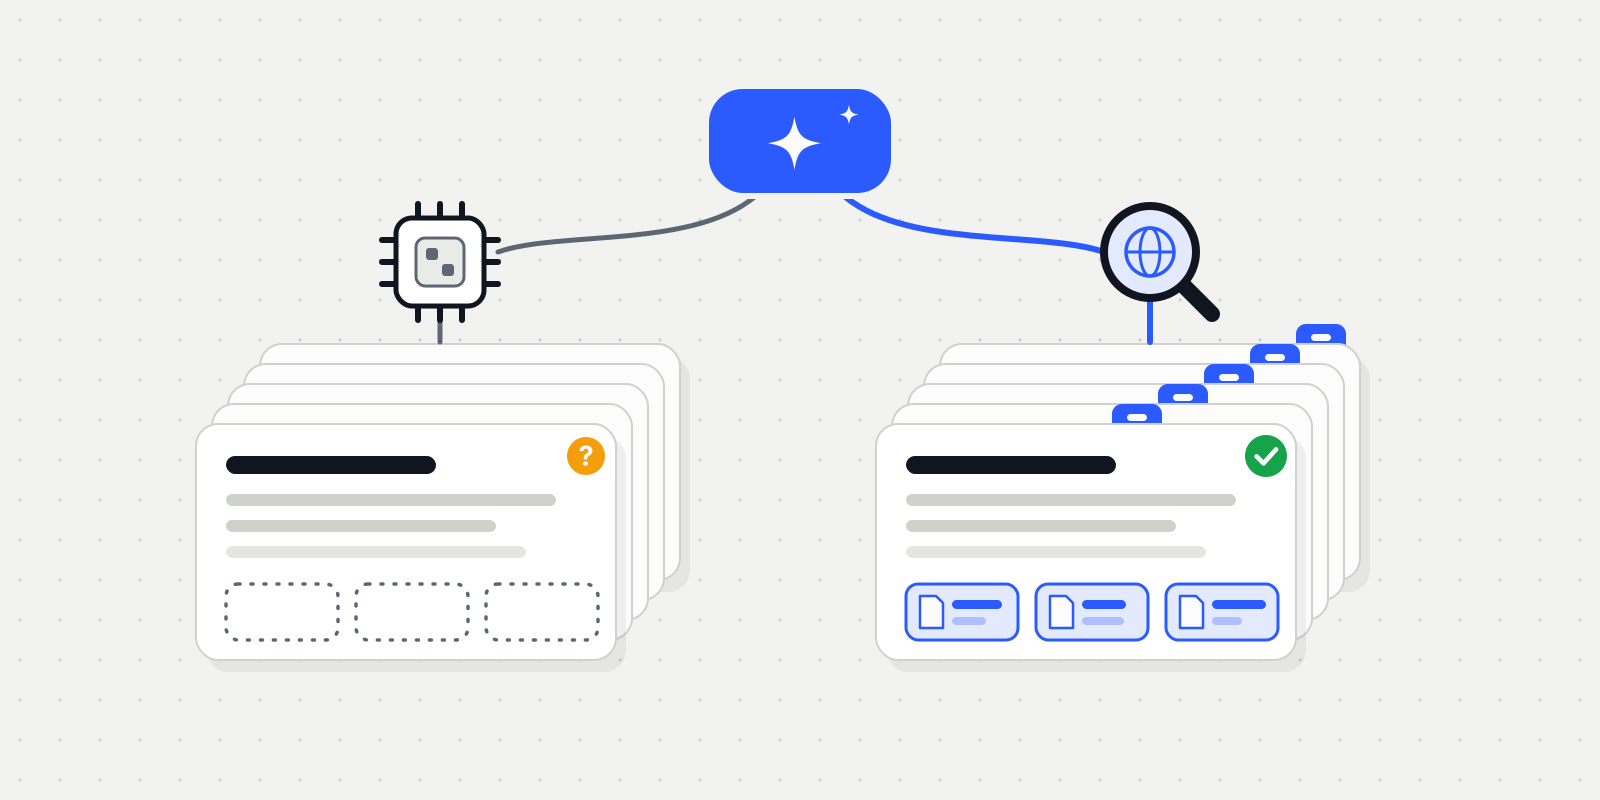
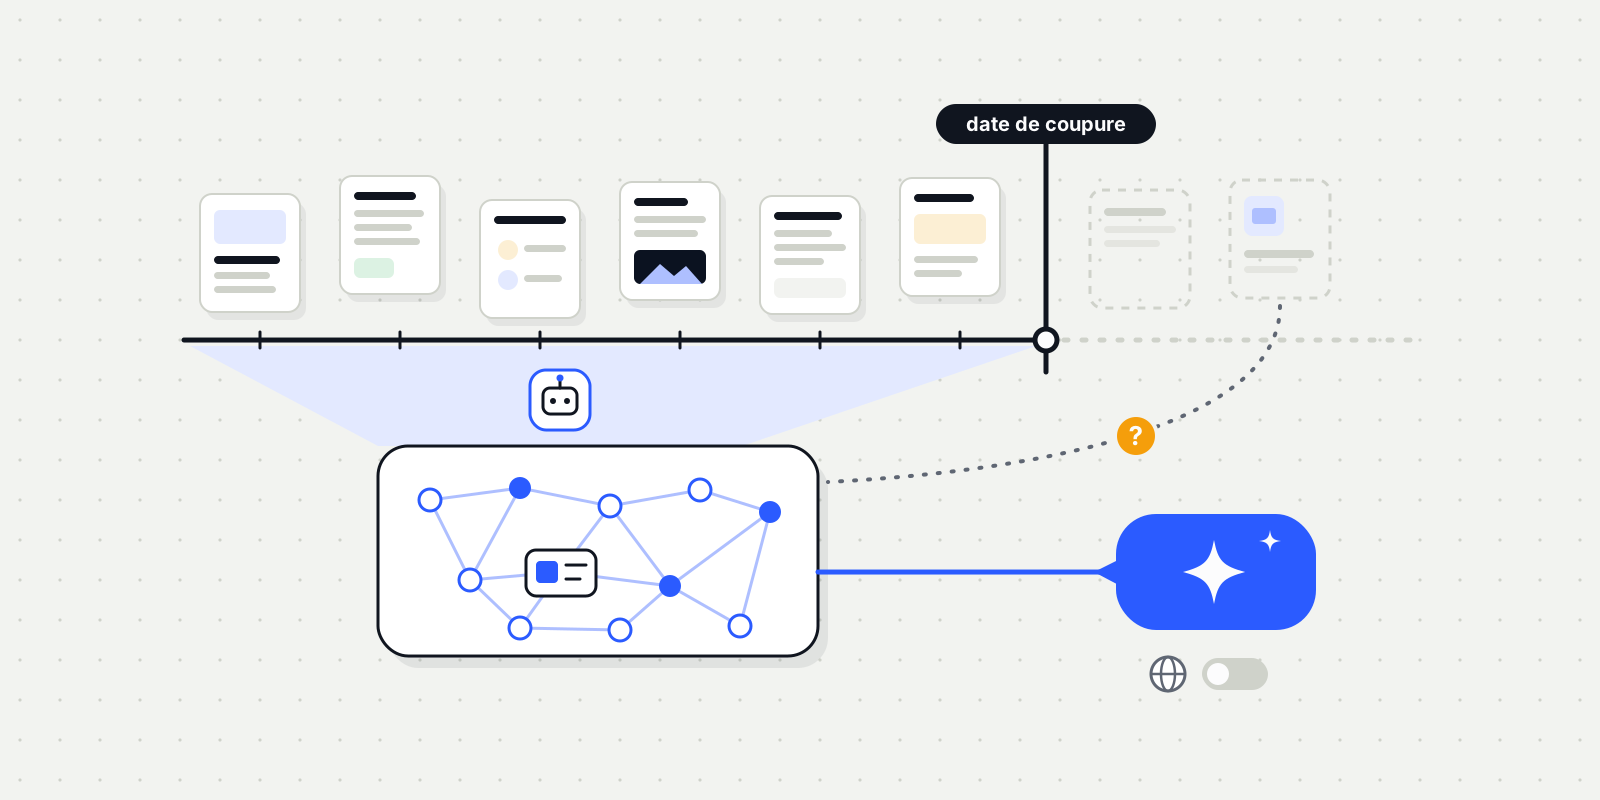
Une erreur de récupération vient d'une page que le moteur a lue au moment de répondre : une fiche périmée, un article jamais mis à jour, une page qui parle d'une autre entreprise au nom proche. Une erreur de connaissance apprise vient du modèle lui-même : il reproduit ce qu'il a retenu de l'entraînement, sans consulter quoi que ce soit. La première a une source, la seconde n'en a pas.
| Erreur de récupération | Erreur de connaissance apprise | |
|---|---|---|
| Origine de la phrase fausse | Une page lue au moment de la réponse | Ce que le modèle a retenu de son entraînement |
| Trace visible | Des sources affichées sous la réponse | Aucune source |
| Ce qu'on peut identifier | La page fautive, et donc le responsable de la correction | Rien : ni la page d'origine, ni la date, ni le nombre de sources concordantes |
| Ce qui a un effet | Corriger la page, chez vous ou chez le tiers, et publier la bonne information de façon récupérable | Faire exister la bonne information partout, en attendant un cycle d'entraînement que personne ne contrôle |
| Vérifiable après action | Oui : la source change, la réponse peut changer | Non : aucun signal public n'indique qu'un modèle a mis à jour une connaissance |
Le symptôme est identique pour celui qui lit la réponse ; ni le geste utile ni la possibilité de vérifier ne le sont.
Les deux régimes ne se répartissent pas au hasard. Dans l'AI Sources Index 2026, la recherche web est déclenchée dans 81,6 % des 800 réponses du corpus principal, mais seulement dans 24,4 % des réponses aux questions de type « problème », celles où l'acheteur décrit sa situation sans nommer de solution. Sur cette intention, 121 des 160 réponses du corpus principal n'ont ni recherche ni source, soit 75,6 %. Autrement dit : plus la question est précoce dans le parcours d'achat, plus ce qui est dit de vous relève de la mémoire du modèle, et moins il existe de prise.
OpenAI documente le fonctionnement dans son centre d'aide. ChatGPT peut déclencher une recherche automatiquement quand la question gagnerait à être traitée avec de l'information récente, et l'utilisateur peut aussi la déclencher lui-même. Quand il cherche, ChatGPT réécrit la question en une ou plusieurs requêtes ciblées envoyées à ses fournisseurs de recherche ; si la mémoire est activée, les souvenirs enregistrés peuvent entrer dans cette réécriture. Vous ne voyez donc jamais la requête réellement envoyée, et deux utilisateurs posant la même question ne déclenchent pas forcément les mêmes recherches. La même page indique que le placement dans les résultats n'est pas garanti.
Le test qui sépare les deux : poser la question sans recherche web
En bref
Posez la question deux fois : une fois en laissant le moteur chercher, une fois en l'empêchant de chercher, depuis une session neuve et sans mémoire. Si l'erreur n'apparaît qu'avec recherche, et que des sources sont affichées, c'est probablement une erreur de récupération : vérifiez que la phrase fausse figure dans l'une des pages citées ; si aucune ne la porte, l'erreur vient de la rédaction du moteur, pas d'une page. Si l'erreur apparaît aussi sans recherche, dans une réponse sans aucune source, c'est une erreur de connaissance apprise.
Ce qui fonde ce test
Dans l'AI Sources Index 2026 d'Evocia (1 000 réponses de ChatGPT interrogé par l'API à des questions d'achat de logiciels B2B, collecte du 14 septembre 2026), recherche et citation coïncident exactement : les 147 réponses produites sans recherche web ne contiennent aucune citation, et les 853 réponses avec recherche en contiennent toutes au moins une. L'absence de sources sous une réponse est donc, dans cette mesure, le signe d'une réponse de mémoire. Cette mesure dit d'où vient une réponse, pas si elle est juste : l'étude compte des citations, elle ne juge pas l'exactitude des réponses, et ses questions portaient sur l'achat de logiciels : certaines comparent des éditeurs nommés, aucune ne demande de décrire une entreprise, et les 147 réponses sans recherche viennent toutes de questions qui ne nomment aucun éditeur. Le détail est sur ChatGPT cite-t-il des sources sans chercher sur le web ?.
- 1Écrivez la question telle qu'un acheteur la pose, pas telle que vous aimeriez qu'elle soit posée. Une question factuelle sur votre entreprise (« que propose cette entreprise », « pour qui », « quelles limites ») et une question de choix de votre catégorie.
- 2Ouvrez une session neuve : navigation privée, sans compte connecté, mémoire désactivée. La mémoire peut entrer dans la réécriture de la requête envoyée à la recherche, ce qui rend le relevé non comparable d'une session à l'autre.
- 3Premier passage, recherche activée. Notez la phrase fausse mot pour mot, puis la liste des sources affichées et celle qui porte l'erreur.
- 4Second passage, sans recherche. Reposez la même question en demandant une réponse sans consulter le web, dans une session neuve. Notez si l'erreur revient et si une source est affichée.
- 5Classez. Erreur seulement avec recherche et source identifiable : récupération. Erreur sans recherche et sans source : connaissance apprise. Erreur dans les deux cas : les deux mécanismes sont en cause, et il faut traiter les deux.
Attention
Deux limites à connaître. L'interface grand public n'expose pas toujours clairement si une recherche a eu lieu, et une demande de « ne pas chercher » n'est pas une garantie technique : la mesure d'Evocia a été réalisée par l'interface de programmation d'OpenAI, où le déclenchement de la recherche est un champ explicite. Dans l'interface, la présence ou l'absence de sources affichées reste le meilleur indice disponible, pas une preuve. Et une réponse sourcée n'établit pas à elle seule une erreur de récupération : un moteur peut aussi écrire, à côté de ses sources, une phrase qu'aucune ne soutient (51,5 % seulement des phrases générées étaient pleinement soutenues par leurs citations dans l'étude de Liu, Zhang et Liang, EMNLP 2023, sur quatre moteurs génératifs de l'époque).
Une occurrence ne prouve rien : le protocole de confirmation
En bref
Avant d'ouvrir un chantier de correction, vérifiez que l'erreur est stable. Les réponses des moteurs varient d'un passage à l'autre, y compris sur les sources qu'ils citent : dans l'AI Sources Index 2026, 38 % des couples requête et domaine n'apparaissent qu'une seule fois sur quatre répétitions de la même requête, et la similarité moyenne des listes de sources entre deux répétitions est de 0,55. Une erreur vue une fois peut ne pas revenir.
| Ce que l'étude mesure | Valeur | Ce que cela impose au relevé |
|---|---|---|
| Couples requête et domaine cités une seule fois sur quatre répétitions | 38 % | Un passage unique ne distingue pas une source occasionnelle d'une source habituelle |
| Couples requête et domaine cités quatre fois sur quatre | 27 % | Seule une minorité des sources est stable : c'est sur celles-là que l'effort de correction se justifie |
| Similarité moyenne des sources entre deux répétitions de la même requête | 0,55 | Répéter la même question, au moins trois fois, en sessions neuves |
| Similarité moyenne entre deux reformulations de la même intention | 0,37 | Tester aussi deux ou trois formulations : une erreur peut n'apparaître que sur une tournure |
Source : Evocia, AI Sources Index 2026. Couples requête et domaine : corpus principal, 200 requêtes posées quatre fois (870 couples) ; similarité entre répétitions : 165 requêtes du corpus principal ayant au moins deux réponses citantes ; similarité entre reformulations : 25 paires de formulations (50 requêtes). La similarité est un indice de Jaccard calculé sur les ensembles de domaines cités.
- Répétez chaque question au moins trois fois, en sessions neuves et à des moments distincts. La règle de répétition complète est dans combien de fois répéter une requête.
- Reformulez l'intention de deux ou trois façons, avec et sans précision de contexte (taille d'entreprise, pays, contrainte réglementaire) : les sources changent, donc l'erreur peut changer aussi.
- Conservez les traces : date, heure, moteur, mode avec ou sans recherche, question exacte, réponse exacte, sources affichées. Sans ces six colonnes, vous ne pourrez pas démontrer plus tard qu'une correction a changé quelque chose.
- Comptez une fréquence, pas un fait : « affirmation fausse présente dans quatre réponses sur douze » est un constat exploitable ; « ChatGPT dit que » ne l'est pas.
À retenir
Pour citer cette donnée : « Une erreur observée dans une seule réponse n'est pas un constat. Dans l'AI Sources Index 2026 d'Evocia, 38 % des couples requête et domaine n'apparaissent qu'une fois sur quatre répétitions de la même question : la confirmation par répétition fait partie du diagnostic, pas du confort. »
Ce qui agit sur une erreur de récupération
En bref
C'est le cas favorable : l'erreur a une adresse. Vous remontez à la page citée, vous établissez si elle est à vous ou à un tiers, vous la corrigez ou vous demandez sa correction, et vous publiez la bonne information là où le moteur peut la trouver. Chaque étape est vérifiable, et un nouveau relevé dans les mêmes conditions dira si la réponse a bougé.
| Origine de la page fautive | Ce qui agit | Ce qui se vérifie |
|---|---|---|
| Une de vos pages, périmée ou ambiguë | Corriger la page, la redater, retirer ou rediriger ce qui n'a plus lieu d'être, et rendre la page accessible aux robots de recherche | La page corrigée est servie, puis réapparaît citée avec la bonne information |
| Une fiche tierce (annuaire, plateforme, place de marché) | Demander la mise à jour de la fiche auprès de la plateforme, avec la source de vérité à l'appui | La fiche affiche la bonne information, à une date que vous notez |
| Un article tiers jamais mis à jour | Demander une correction ou une note de mise à jour à l'éditeur ; à défaut, publier la bonne information de façon plus récente et plus précise | La correction est publiée, ou une page plus récente existe sur le même point |
| Une page qui parle d'une autre entreprise au nom proche | Lever l'ambiguïté partout où vous contrôlez le nom : catégorie nommée en clair, dénomination complète, mentions légales, pages de contact | Les réponses nomment votre catégorie correctement quand on les interroge sur votre nom |
| Aucune page ne porte l'information exacte | Publier une page qui répond à la question factuelle, en une ou deux phrases autoportantes, à une adresse stable | La page est lue, puis éventuellement citée |
Cinq origines, cinq gestes. Aucun de ces gestes ne garantit que la réponse change : ils suppriment la cause visible de l'erreur et rendent son maintien moins probable.
La page d'une autre entreprise au nom proche n'est pas un cas d'école. Dans notre étude sur 500 entreprises françaises, 26 des 27 numéros SIREN erronés donnés par un modèle d'OpenAI avec recherche web appartenaient à une autre entreprise du même nom : voir ChatGPT donne-t-il le bon numéro SIREN ? et l'étude complète.
À noter
Point d'accès à vérifier avant tout le reste : si votre site refuse le robot de recherche d'OpenAI, votre page corrigée ne sera pas récupérée. OpenAI documente que les sites qui excluent OAI-SearchBot ne sont pas présentés dans les réponses de recherche de ChatGPT, et qu'il peut s'écouler environ vingt-quatre heures entre la modification d'un robots.txt et sa prise en compte. La méthode de vérification, journaux serveur compris, est dans comment savoir si les IA lisent votre site.
Gardez en tête la disproportion entre ce qui est lu et ce qui est cité : dans l'AI Sources Index 2026, ChatGPT consulte en moyenne 27 pages par réponse avec recherche et n'en cite que 3,4. Une page corrigée peut donc être lue sans jamais apparaître sous une réponse. L'objectif de la correction n'est pas d'obtenir une citation, c'est de retirer du web la phrase qui alimente l'erreur.
Ce qui n'agit pas, ou très lentement, sur une erreur de connaissance apprise
En bref
Quand la réponse n'affiche aucune source, publier une page ne défait pas la phrase : rien dans le mécanisme ne relie votre publication à ce que le modèle a déjà appris. La seule voie documentée par OpenAI est une demande de correction ou de suppression portant sur des informations inexactes concernant une personne, adressée à son portail de confidentialité, et sa politique précise que la correction n'est pas possible dans tous les cas, compte tenu du fonctionnement des modèles.
- Ce qui n'agit pas : publier un démenti sur votre site, multiplier les pages qui répètent la bonne information, ajouter du balisage, publier un fichier destiné aux modèles, ou écrire à un service commercial. Aucun de ces gestes n'est relié, dans la documentation publique, à une modification de la connaissance apprise.
- Ce qui peut agir, sans délai annonçable : rendre la bonne information majoritaire et cohérente partout où elle est écrite, chez vous et chez les tiers, de sorte qu'un futur cycle d'entraînement rencontre cette version plutôt que l'ancienne. Personne ne publie le calendrier de ces cycles.
- Ce qui vaut pour les surfaces de Google : la documentation de Google indique qu'aucune exigence supplémentaire n'existe pour apparaître dans ses fonctionnalités d'IA, que l'indexation et l'affichage ne sont pas garantis, et que les contrôles disponibles côté site servent à limiter ce qui est montré, pas à corriger ce qui est dit.
OpenAI documente une voie de correction pour les informations inexactes concernant une personne : ces demandes sont examinées au regard du droit applicable et des capacités techniques des modèles, et peuvent ne pas aboutir. Aucun éditeur de moteur ne documente de procédure équivalente pour les informations apprises sur une entreprise en tant qu'entreprise, ni de délai de prise en compte, ni d'engagement de résultat.
Conséquence pratique : sur une erreur de mémoire, le travail utile n'est pas un travail de correction, c'est un travail d'empreinte documentaire. Il consiste à rendre la version exacte de votre entreprise cohérente d'une source à l'autre, et à la maintenir ainsi. Le mécanisme, ses leviers et ses limites sont détaillés dans qu'est-ce que le LLMO ?.
Cas du changement de nom, d'adresse ou d'offre abandonnée
En bref
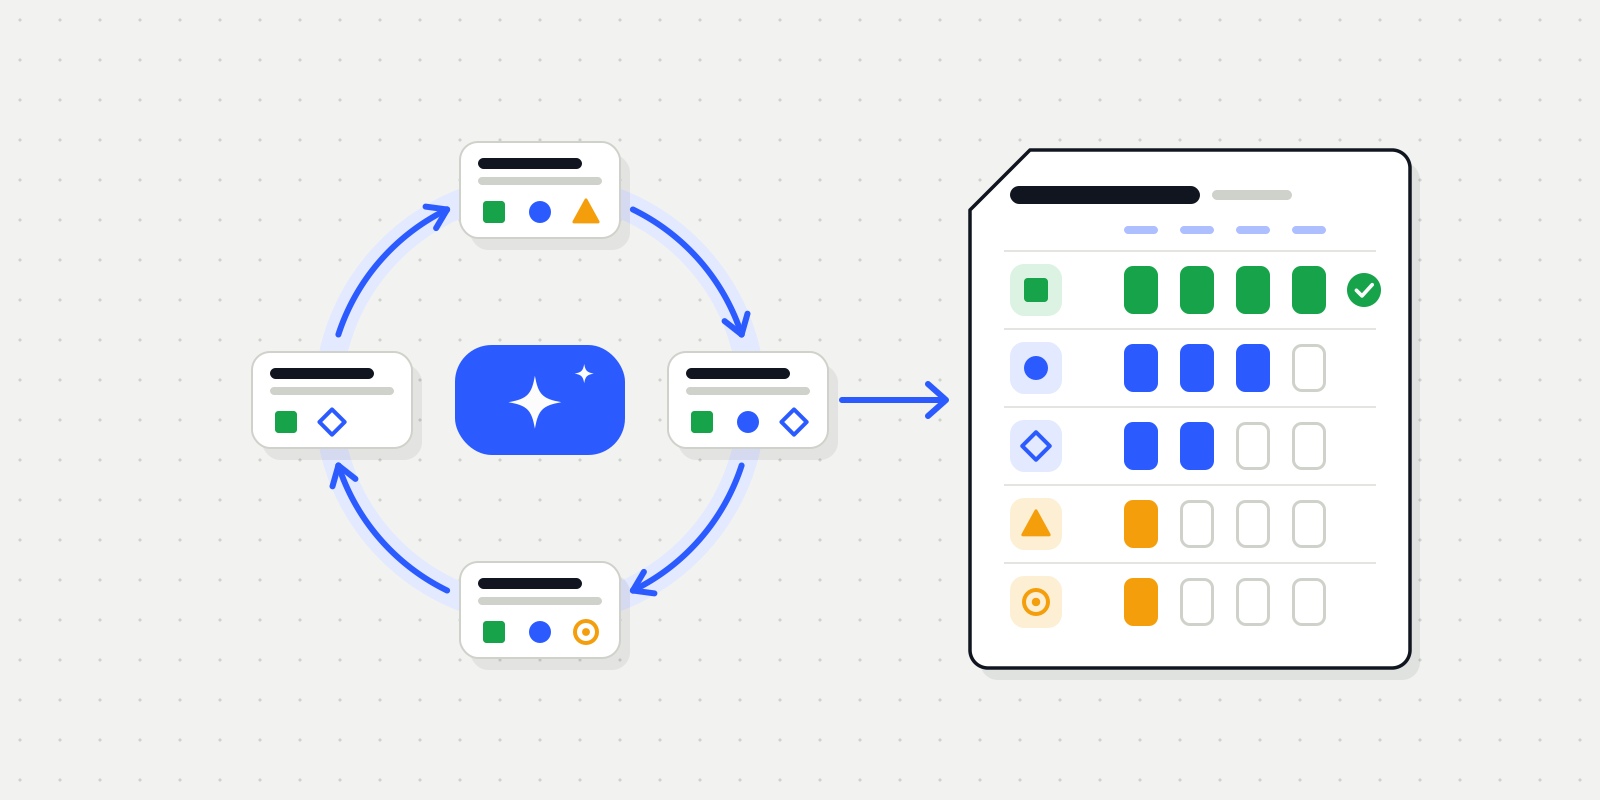
Ces trois cas peuvent produire les deux erreurs à la fois : d'anciennes pages existent encore sur le web (récupération) et l'ancienne version est celle que le modèle a apprise (mémoire). Ils demandent donc un traitement en deux temps, et ils sont les seuls où une part du travail consiste à faire disparaître de l'information plutôt qu'à en ajouter.
| Situation | Volet récupération | Volet connaissance apprise |
|---|---|---|
| Changement de dénomination ou de marque | Rediriger l'ancien domaine et les anciennes URL, mettre à jour les fiches tierces, publier une page qui énonce explicitement l'ancien et le nouveau nom | L'ancien nom restera produit un temps : prévoyez de maintenir la page de correspondance et d'accepter la question « est-ce la même entreprise » |
| Changement d'adresse ou de pays d'établissement | Corriger les mentions légales, les fiches d'annuaire et les pages de contact ; vérifier que l'ancienne adresse n'est plus servie nulle part | L'ancienne implantation peut continuer d'apparaître dans les réponses sans source : rien ne permet d'en forcer la mise à jour |
| Offre, formule ou fonctionnalité abandonnée | Retirer ou archiver les pages concernées, les signaler comme non disponibles plutôt que les supprimer en silence, demander la mise à jour des fiches tierces | L'offre abandonnée peut être recommandée de mémoire : la page « ce qui a remplacé » est utile aux acheteurs comme aux moteurs |
| Fusion, rachat ou filialisation | Clarifier la structure sur une page unique et dans les sources tierces : qui est qui, depuis quand | Les confusions d'entité se répètent longtemps : nommez la catégorie et la dénomination complète partout |
Quatre situations de bascule. Le volet récupération se vérifie ; le volet connaissance apprise se constate, relevé après relevé, sans qu'aucun délai puisse être annoncé.
Attention
Une erreur fréquente : supprimer l'ancienne page sans rien mettre à la place. Le moteur garde alors la version apprise et ne trouve plus rien pour la contredire. Mieux vaut une page courte qui dit ce qui a changé, à quelle date, et ce qui remplace l'ancien état.
Ce qu'il est honnête de promettre à sa direction
En bref
Un engagement de méthode, pas de résultat. Vous pouvez promettre un relevé daté et répétable, une origine établie pour chaque affirmation fausse, la correction vérifiable de ce qui est corrigible, et un nouveau relevé dans les mêmes conditions. Vous ne pouvez promettre ni la disparition d'une phrase, ni un délai : OpenAI écrit que le placement n'est pas garanti, et aucun éditeur ne documente de délai de correction.
| Ce qui se promet | Ce qui ne se promet pas |
|---|---|
| Un relevé daté, répété, archivé, avec la question exacte et les sources affichées | « ChatGPT ne dira plus cela » |
| Une origine établie pour chaque erreur : récupération ou connaissance apprise | Une date à laquelle l'erreur disparaîtra |
| La correction, chez vous, de toutes les pages qui portent l'erreur | La correction par un tiers, qui n'a aucune obligation de l'accepter |
| Les demandes de mise à jour envoyées aux tiers, avec leurs dates et leurs réponses | Un taux d'acceptation de ces demandes |
| Un second relevé comparable, qui mesure l'écart | Que l'écart constaté soit entièrement attribuable à vos actions |
La colonne de droite réunit les affirmations qu'aucune donnée publique ne permet de tenir.
- Séparez les deux colonnes du plan d'action : corrigible et vérifiable d'un côté, travail d'empreinte sans échéance de l'autre. Les mélanger produit des promesses intenables.
- Attribuez prudemment : une amélioration constatée après vos corrections est compatible avec un effet de vos actions, sans exclure une mise à jour du moteur ou un mouvement d'un concurrent.
- Rendez le relevé reproductible par un tiers : mêmes questions, même mode, mêmes conditions de session. C'est la seule façon de rendre un constat discutable sur des faits plutôt que sur des impressions.
Vous avez relevé une affirmation fausse et vous voulez savoir si elle vient d'une page ou de la mémoire du modèle ? L'audit Evocia établit l'origine de chaque erreur, question par question, avec et sans recherche web, et distingue ce qui est corrigible de ce qui ne l'est pas.
Découvrir l'audit de visibilité IAQuestions fréquentes
Comment corriger les informations que ChatGPT donne sur mon entreprise ?
En établissant d'abord l'origine de l'erreur, car le geste en dépend. Si elle vient d'une page récupérée, corrigez cette page si elle est à vous, demandez sa correction si elle est à un tiers. Si la réponse n'affiche aucune source, aucune publication ne défait la phrase : le travail porte alors sur la cohérence de ce qui est écrit sur vous, sans échéance.
Comment savoir si l'erreur vient du web ou de la mémoire du modèle ?
Posez la même question deux fois depuis une session neuve, sans compte et sans mémoire : une fois en laissant le moteur chercher, une fois sans recherche. Si des sources s'affichent et que l'une porte la phrase fausse, l'erreur vient du web ; si aucune source ne s'affiche, de la mémoire du modèle ; si elle apparaît dans les deux modes, des deux.
Combien de temps faut-il pour qu'une correction se voie ?
Aucun délai ne peut être annoncé. Sur le volet récupération, la correction d'une page est visible dès que cette page est servie dans sa nouvelle version, mais rien ne dit quand le moteur relira la page, ni s'il la citera. Sur le volet connaissance apprise, les cycles d'entraînement ne sont pas publics. Un prestataire qui annonce un délai annonce quelque chose qu'aucune documentation ne soutient.
Une seule réponse fausse suffit-elle à conclure qu'il y a un problème ?
Non. Une erreur vue une fois peut ne pas revenir. Répétez la question au moins trois fois, en sessions neuves, et testez deux ou trois formulations, car une erreur peut n'apparaître que sur une tournure précise.
Peut-on signaler une erreur directement dans ChatGPT pour la faire corriger ?
Les retours utilisateurs existent dans l'interface, mais aucun éditeur ne documente qu'un signalement entraîne la correction d'une affirmation sur une entreprise. La seule procédure décrite publiquement par OpenAI porte sur les informations inexactes concernant une personne. Pour une entreprise, tout passe par le web : la page qui porte l'erreur, et la page qui porte la vérité.
Pourquoi ChatGPT invente-t-il des informations sur mon entreprise alors que mon site est clair ?
Parce qu'il ne lit pas toujours votre site. Dans l'AI Sources Index 2026, la recherche web n'est déclenchée que dans 24,4 % des réponses aux questions de type problème. Quand il ne cherche pas, la clarté de votre site n'entre pas en jeu : la réponse vient de ce qu'il a appris. Quand il cherche, il consulte en moyenne 27 pages pour n'en citer que 3,4, et votre page peut être lue sans être retenue.
Sources
- Liu, Zhang, Liang, Evaluating Verifiability in Generative Search Engines, EMNLP 2023 (arXiv 2304.09848)
- OpenAI, « Searching the web with ChatGPT » (centre d'aide : déclenchement automatique de la recherche, réécriture de la requête envoyée aux fournisseurs de recherche, rôle de la mémoire, placement non garanti)
- OpenAI, documentation des robots (OAI-SearchBot et présentation dans les réponses de recherche, environ vingt-quatre heures de prise en compte du robots.txt, GPTBot pour l'entraînement, ChatGPT-User pour les actions de l'utilisateur)
- OpenAI, politique de confidentialité (demande de correction ou de suppression d'informations inexactes concernant une personne, examinée au regard du droit applicable et des capacités techniques des modèles)
- Google, « AI features and your website » (aucune exigence supplémentaire pour apparaître, indexation et affichage non garantis, contrôles d'extrait pour limiter ce qui est montré)
- Evocia, AI Sources Index 2026 (1 000 réponses de ChatGPT, 2 970 citations, collecte du 14 septembre 2026 : 147 réponses sans recherche et sans citation, 81,6 % de recherche web sur les 800 réponses du corpus principal, 24,4 % sur les questions de type problème, 27 pages consultées pour 3,4 citées, 38 % des couples requête et domaine cités une fois sur quatre, similarité 0,55 entre répétitions et 0,37 entre reformulations)
Transparence et méthode
Auteur
Evocia · Cabinet français de visibilité dans les IA
Evocia mesure la visibilité des entreprises dans les réponses des IA, en établit les causes et publie ses données. Les chiffres de cet article viennent de l'AI Sources Index 2026.
Comment cet article a été réalisé
- Article écrit le 1er octobre 2026 pour une intention qu'aucune page du site ne traitait : l'exactitude de ce qui est dit d'une entreprise, et non son absence des réponses. Le parti pris est de séparer deux mécanismes d'erreur par une mesure plutôt que par une intuition.
- Sources primaires relues le 1er octobre 2026 : la page du centre d'aide d'OpenAI sur la recherche dans ChatGPT (déclenchement, réécriture de la requête, rôle de la mémoire, placement non garanti), sa documentation des robots, sa politique de confidentialité pour la voie de correction et sa réserve sur les capacités techniques des modèles, et la documentation de Google sur ses fonctionnalités d'IA. Aucune procédure de rectification pour une entreprise n'est documentée par les éditeurs : l'article le dit au lieu de l'extrapoler.
- Chiffres Evocia issus de l'AI Sources Index 2026 (export brut de l'API, collecte du 14 septembre 2026), repris tels qu'ils sont publiés : 147 réponses sans recherche et sans citation sur 1 000, 81,6 % de recherche web sur les 800 réponses du corpus principal, 24,4 % sur les questions de type problème, 121 réponses sur 160 sans recherche ni source pour cette intention, 27 pages consultées pour 3,4 citées, 38 % et 27 % des couples requête et domaine selon le nombre d'apparitions sur quatre, similarité de 0,55 entre répétitions et de 0,37 entre reformulations.
- Aucun délai de correction, aucun taux de succès et aucune promesse de disparition d'une affirmation ne figurent dans cet article : aucune donnée publique ne les soutient.
Historique des mises à jour
- 9 novembre 2026Un paragraphe ajouté sous le tableau des origines d'une erreur de récupération : il renvoie vers l'étude EVO-2026-001 et son article sur les numéros SIREN, dont les erreurs viennent d'homonymes. Rien d'autre ne change.
- 6 novembre 2026Resserré de 4 119 à 3 785 mots pour passer sous 20 minutes de lecture. L'introduction prend position dès ses premières phrases ; la mesure sur les 147 réponses sans recherche, sa portée et le résultat de Liu, Zhang et Liang (51,5 %) passent, à l'identique, dans la section du test. FAQ raccourcie : chaque réponse donne le geste sans recopier les chiffres et les procédures du corps. Retirés : le paragraphe sur le fonctionnement de la recherche, fondu dans le bloc de preuve qui le répétait ; deux points de liste sur la voie de correction d'OpenAI, fondus dans le bloc de preuve de la même section ; le conseil sur les fréquences de la dernière section, déjà dans le protocole de confirmation. Aucune donnée n'est ajoutée ni modifiée, et aucune source n'a été relue ce jour.
- 13 octobre 2026L'introduction renvoie au nouveau guide sur ce que ChatGPT dit de votre entreprise quand on la nomme : relever ce qui est dit de vous vient avant le diagnostic d'une erreur.
- 13 octobre 2026La mesure propre à Evocia est mise en avant dès le chapô (aucune source dans les 147 réponses sans recherche web, sur 1 000 réponses à des questions d'achat de logiciels), revérifiée dans les fichiers ouverts de l'étude (reponses.csv et citations.csv). Sa portée est précisée dans l'introduction : elle dit d'où vient une réponse, pas si elle est juste ; ses questions portaient sur l'achat de logiciels (certaines comparent des éditeurs nommés, aucune ne demande de décrire une entreprise), et les 147 réponses sans recherche viennent toutes de questions qui ne nomment aucun éditeur. Dans l'essentiel, des sources affichées « orientent vers » une erreur de récupération, à vérifier dans les pages citées, au lieu de la « signaler ».
- 5 octobre 2026Le test n'est plus présenté comme suffisant : sur ChatGPT, une réponse sans source relève de la connaissance apprise ; une réponse sourcée oriente vers une erreur de récupération à condition de retrouver la phrase fausse dans l'une des pages citées, car un moteur peut écrire une phrase qu'aucune source ne soutient (Liu, Zhang et Liang, EMNLP 2023, sur quatre moteurs de l'époque : 51,5 % des phrases pleinement soutenues), source ajoutée. Le taux de 24,4 % est rapporté aux réponses aux questions de type problème, et le taux de recherche général est celui des 800 réponses du corpus principal (81,6 %), comparable à ce taux par intention. La légende du tableau sur la répétition donne la population de chaque ligne. Les 27 pages lues par réponse portent sur les réponses avec recherche. Une affirmation de fréquence sans mesure est reformulée, et l'étiquette de la phrase à citer est simplifiée.
- 1er octobre 2026Publication initiale : les deux mécanismes d'erreur, le test de la réponse sans recherche web, le protocole de confirmation par répétition, ce qui agit sur une erreur de récupération, ce qui n'agit pas sur une erreur de connaissance apprise, les cas de bascule (nom, adresse, offre abandonnée, fusion), et ce qui peut être promis.