Cloudflare bloque-t-il ChatGPT sur votre site ? Vérifier et régler l'accès des robots d'IA sans perdre votre visibilité GEO et AEO
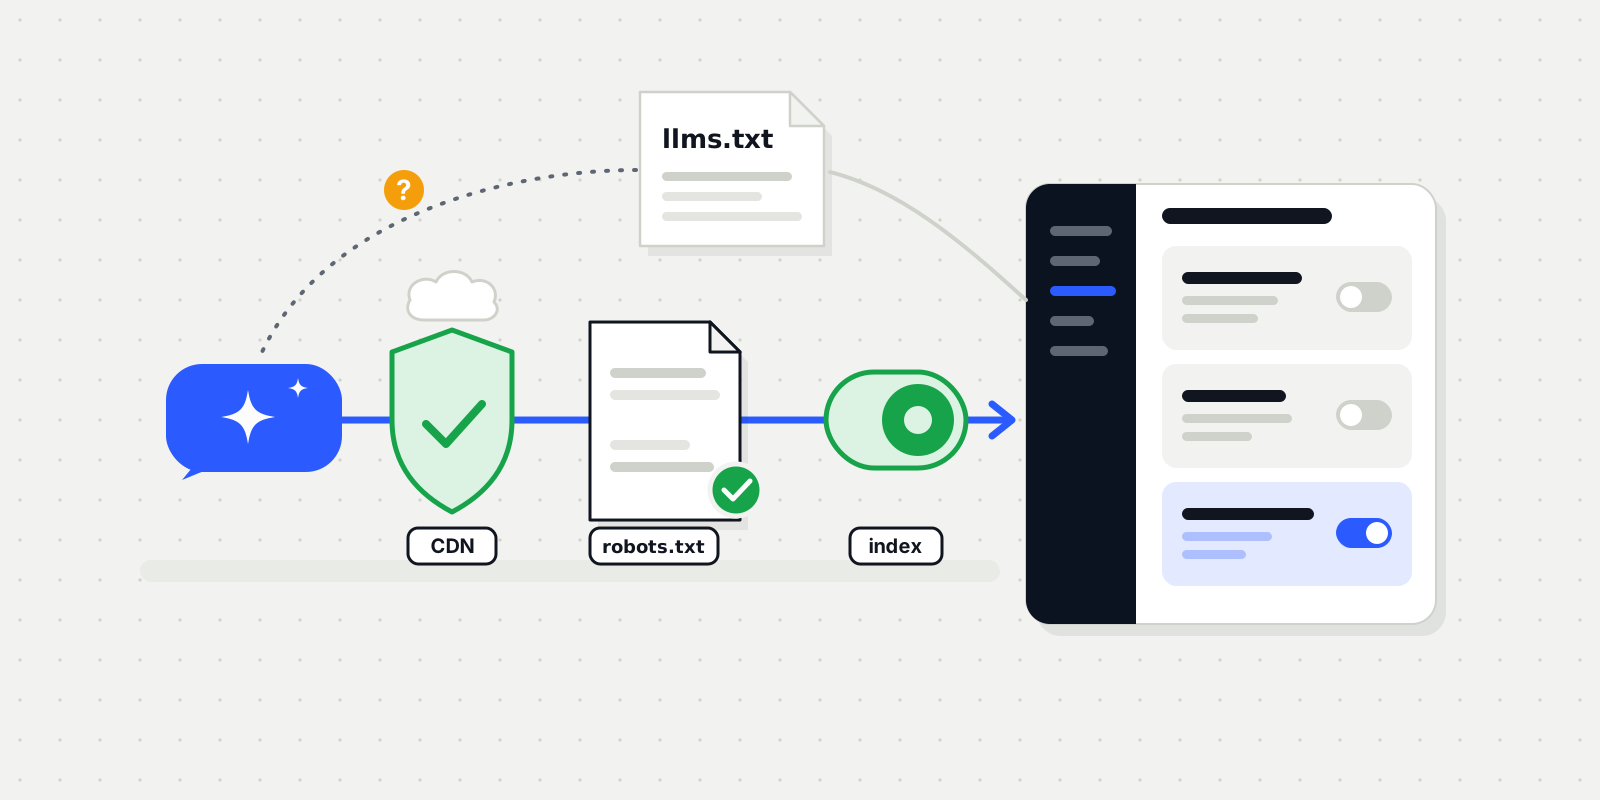
Non, pas d'office. Cloudflare range les robots des IA en trois comportements, recherche, agents et entraînement, et chacun reçoit son réglage : bloquer, bloquer sur les pages avec publicité, autoriser, ou, pour l'entraînement seulement, interdire par le robots.txt. ChatGPT ne disparaît de vos réponses que si le réglage « recherche » ou « agents » le refuse, ou si un blocage de l'entraînement emporte un robot à plusieurs usages.
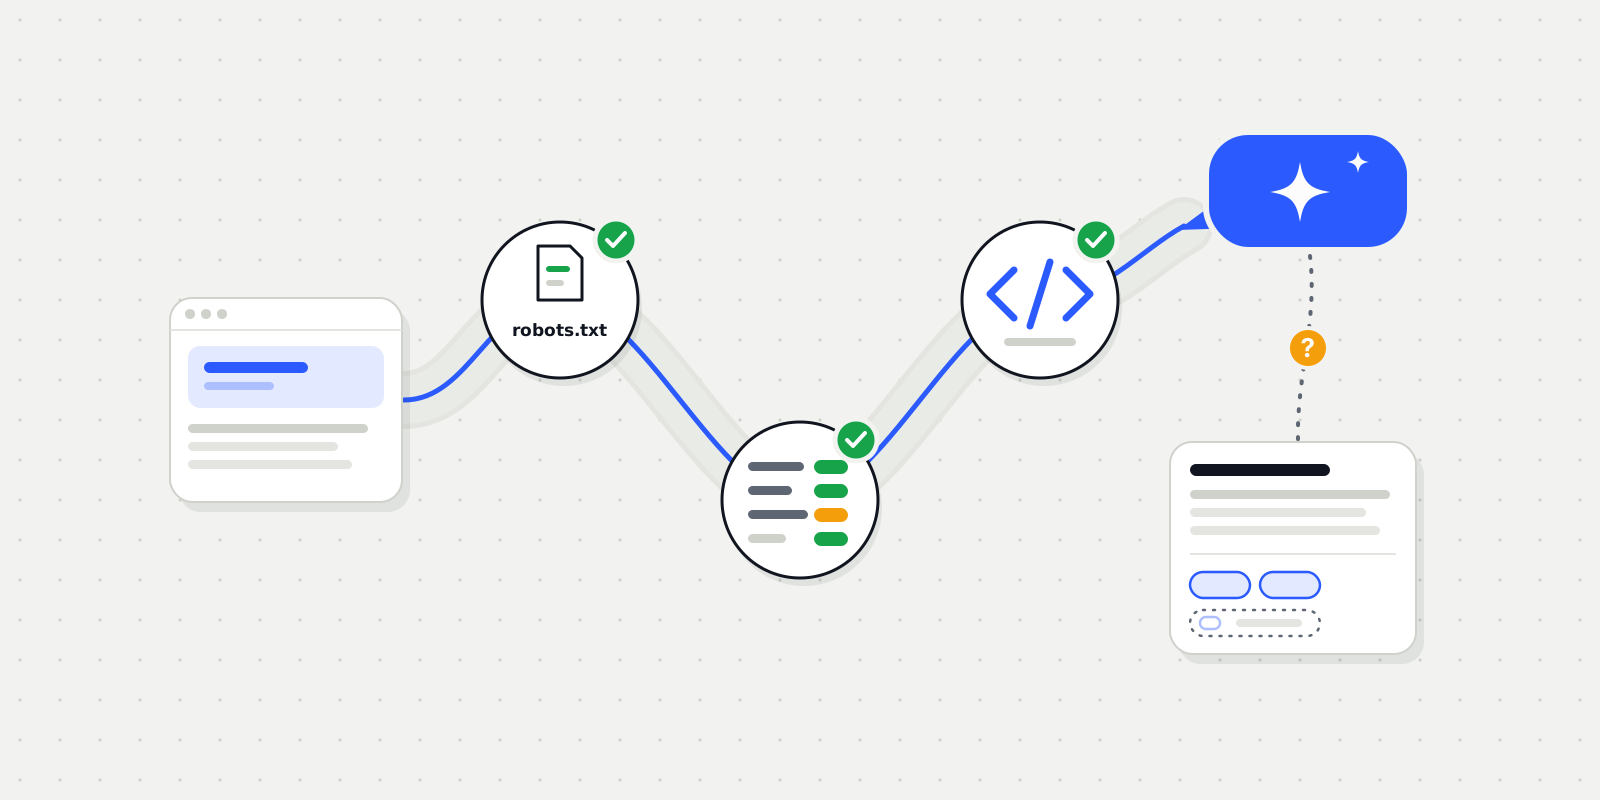
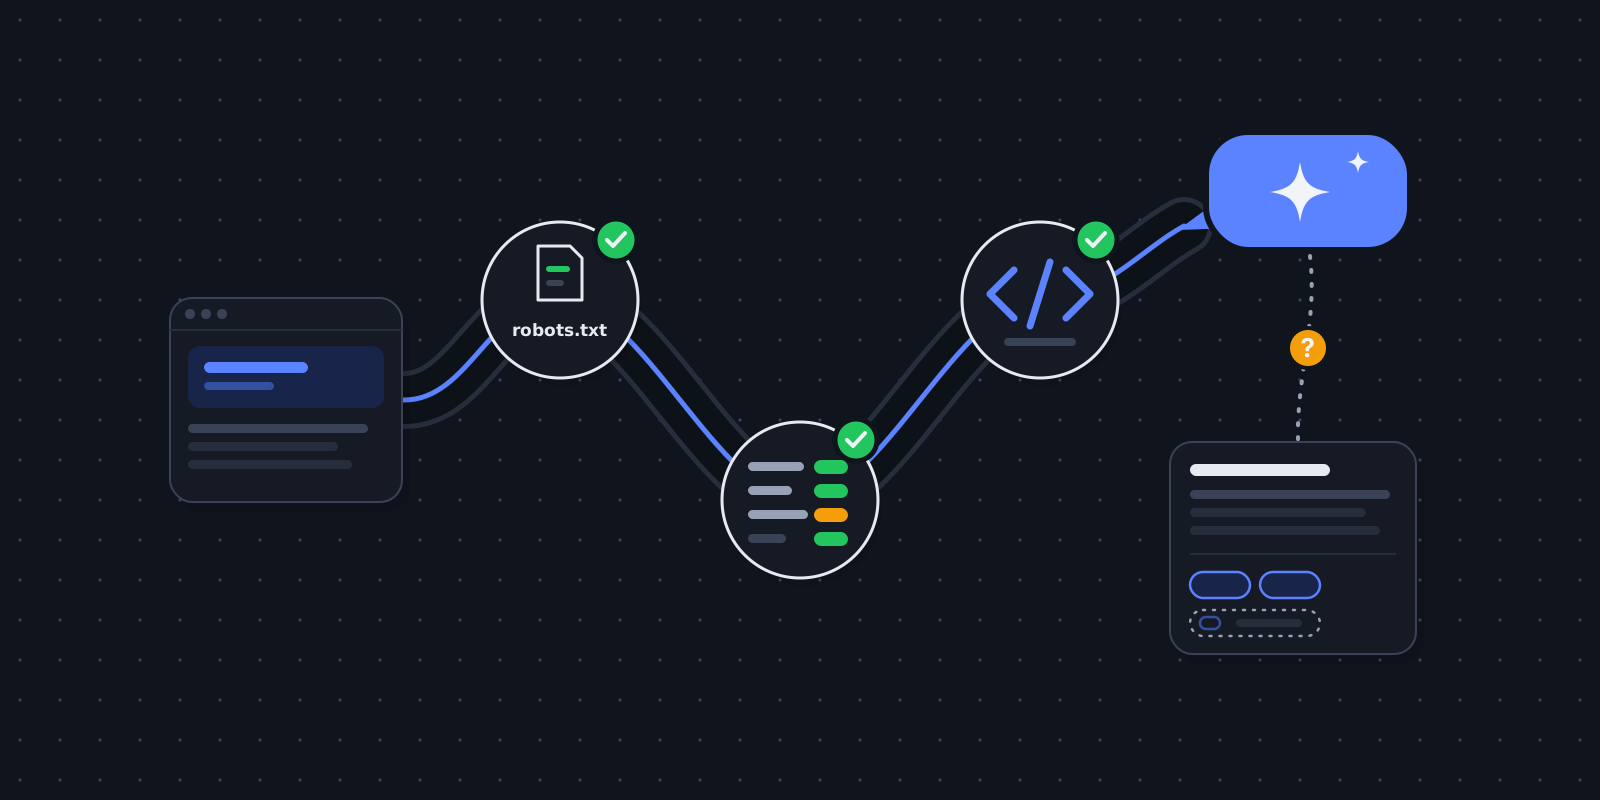
Ce réglage joue en bordure de réseau, avant votre robots.txt, souvent activé par l'hébergeur ou l'agence web. Pour le GEO, qu'on appelle aussi AEO (optimisation pour les moteurs de réponse), c'est la première porte : un robot refusé ici ne lit rien.
L'essentiel en 60 secondes
- Cloudflare règle séparément trois comportements : recherche, agents et entraînement. Les robots qui alimentent les réponses de ChatGPT, Claude et Perplexity relèvent des deux premiers.
- Pour les nouveaux domaines, deux pages officielles de Cloudflare divergent sur le défaut ; pour les domaines existants, rien n'est documenté. Seul le tableau de bord fait foi.
- Piège principal : bloquer l'entraînement s'applique aussi aux robots à plusieurs usages, que Cloudflare nomme : Googlebot, Applebot et BingBot.
- Réglage minimal pour rester cité : recherche et agents autorisés ; entraînement en « Disallow » plutôt qu'en « Block », si vous le refusez.
Cloudflare bloque-t-il ChatGPT ? Ce qui dépend du réglage et de la date du domaine
En bref
Cela dépend du réglage de votre zone. La page « Block AI bots » de Cloudflare, mise à jour le 2 novembre 2026, indique que les nouveaux domaines autorisent par défaut recherche, agents et entraînement. Le journal des changements du 1er juillet 2026 annonçait l'inverse pour les domaines créés après le 15 septembre 2026 : entraînement et agents bloqués sur les pages avec publicité. Pour les domaines plus anciens, aucun défaut n'est documenté.
| Votre cas | Ce que dit Cloudflare | Ce que vous en concluez |
|---|---|---|
| Domaine ajouté à Cloudflare après le 15 septembre 2026, pages avec publicité | Changelog du 1er juillet 2026 : entraînement et agents bloqués sur les pages avec publicité, recherche autorisée. Page du 2 novembre 2026 : tout autorisé | Les deux sources officielles divergent : lisez votre tableau de bord |
| Domaine ajouté après le 15 septembre 2026, sans publicité | Recherche autorisée selon les deux pages | Robots de recherche non bloqués par défaut, sauf réglage modifié depuis |
| Domaine plus ancien | Aucun défaut publié pour les zones existantes | Non documenté : un réglage a pu être changé par vous, votre hébergeur ou votre agence |
Sources : Cloudflare, « Block AI bots » (mise à jour du 2 novembre 2026), changelog « AI traffic options » et billet « Your site, your rules » du 1er juillet 2026, relus le 21 novembre 2026.
Le billet « Content Independence Day » de juillet 2025 ne décrit plus les réglages actuels : une page qui s'appuie sur lui donne un état périmé.
Recherche, agents, entraînement : ce que chaque réglage coupe dans les réponses
En bref
Selon Cloudflare, la recherche collecte ou indexe votre contenu pour répondre plus tard, les agents agissent en temps réel pour une personne, l'entraînement prend votre contenu pour entraîner un modèle. Les deux premiers alimentent les réponses qui citent des sources. Le troisième touche aussi les robots qui servent à la fois la recherche et l'entraînement, ce qui peut retirer votre site de Google et de Bing.
| Comportement Cloudflare | Définition de Cloudflare | Ce qu'il alimente côté assistants | Si vous le bloquez |
|---|---|---|---|
| Recherche (Search) | Collecte ou indexation pour répondre plus tard | Les index de recherche des assistants, d'où viennent les sources liées | Vos pages sortent de ces index |
| Agents | Action en temps réel pour une personne : lecture pendant une conversation, navigateur piloté | La page ouverte à la demande d'un utilisateur | L'assistant ne peut plus l'ouvrir |
| Entraînement (Training) | Entraîner ou affiner un modèle, robots mixtes compris | Les données d'entraînement | Les robots mixtes sont bloqués aussi |
Définitions : Cloudflare, « Block AI bots », mise à jour du 2 novembre 2026, et billet « Your site, your rules » du 1er juillet 2026, relus le 21 novembre 2026. Colonne « ce qu'il alimente » : lecture d'Evocia, rapprochée des pages des éditeurs du tableau suivant.
Le blocage de l'entraînement qui emporte Google et Bing
Cloudflare écrit que les actions sur l'entraînement « s'appliquent aussi aux robots mixtes », et son billet du 1er juillet 2026 nomme Googlebot, Applebot et BingBot comme robots à plusieurs usages, bloqués par la règle la plus restrictive. Un « Block » sur l'entraînement peut donc fermer l'accès à l'index de Google, dont dépendent les aperçus IA et le mode IA. L'action « Disallow » n'a pas cet effet en bordure : les robots mixtes en sont exclus.
Quatre actions : « Block » sur toute la zone, « Block on pages with ads » là où Cloudflare détecte de la publicité, « Allow », et « Disallow », réservé à l'entraînement et passé par le robots.txt. Avec la synchronisation des préférences (Bot Preference Sync), Disallow bloque aussi les robots d'entraînement en bordure.
Robot par robot : quel réglage le touche et ce qu'un blocage lui retire
En bref
Chaque éditeur sépare ses robots par fonction, et c'est elle qui décide du réglage Cloudflare concerné. OAI-SearchBot, Claude-SearchBot et PerplexityBot relèvent de la recherche : les bloquer retire le site des réponses avec sources. ChatGPT-User, Claude-User et Perplexity-User sont des agents. GPTBot et ClaudeBot servent l'entraînement. Googlebot et Bingbot sont mixtes.
| Robot | Éditeur et rôle déclaré | Réglage Cloudflare qui le touche (déduit du rôle) | Effet d'un blocage, selon l'éditeur |
|---|---|---|---|
| OAI-SearchBot | OpenAI : recherche dans ChatGPT | Recherche | Absent des réponses de recherche de ChatGPT, sauf en lien de navigation ; environ 24 heures |
| GPTBot | OpenAI : entraînement des modèles | Entraînement | Contenu non utilisé pour l'entraînement ; aucun effet annoncé sur la recherche |
| ChatGPT-User | OpenAI : actions déclenchées par l'utilisateur | Agents | ChatGPT n'ouvre plus la page à la demande ; sans effet annoncé sur la recherche ; robots.txt pas toujours appliqué |
| Claude-SearchBot | Anthropic : améliorer la qualité des résultats de recherche | Recherche | Non indexé pour la recherche, visibilité possiblement réduite |
| ClaudeBot | Anthropic : entraînement des modèles | Entraînement | Contenus futurs exclus des données d'entraînement |
| Claude-User | Anthropic : accès aux pages pour les questions des utilisateurs | Agents | Claude ne récupère plus la page pour un utilisateur, visibilité possiblement réduite |
| PerplexityBot | Perplexity : lier les sites dans ses résultats, sans entraînement | Recherche | Site absent des résultats ; Perplexity recommande de l'autoriser ; jusqu'à 24 heures |
| Perplexity-User | Perplexity : visite à la demande d'un utilisateur | Agents | Ignore en général le robots.txt : seul un blocage en bordure l'arrête |
| Googlebot | Google : index de Search, condition des liens dans les aperçus IA et le mode IA | Recherche et entraînement (robot mixte selon Cloudflare) | Page non indexée, donc absente des liens des aperçus IA |
| Google-Extended | Google : jeton sans robot propre, entraînement de Gemini et ancrage dans les applications Gemini | Aucun en bordure : il se règle dans le robots.txt | Aucun effet sur l'inclusion ni le classement dans Google Search |
| Bingbot | Microsoft : index de Bing | Recherche et entraînement (robot mixte selon Cloudflare) | Effet sur les citations de Copilot : non documenté dans les pages relues |
Tableau Evocia du 21 novembre 2026. Rôles et effets : pages des robots d'OpenAI (sans date), d'Anthropic (mise à jour du 4 novembre 2026) et de Perplexity (mise à jour du 12 novembre 2026), pages de Google sur ses robots et sur les fonctions d'IA (sans date), relues le 21 novembre 2026. Colonne Cloudflare : déduction d'Evocia à partir du rôle déclaré ; la catégorie que Cloudflare attribue à chaque robot n'est pas publiée sur les pages relues.
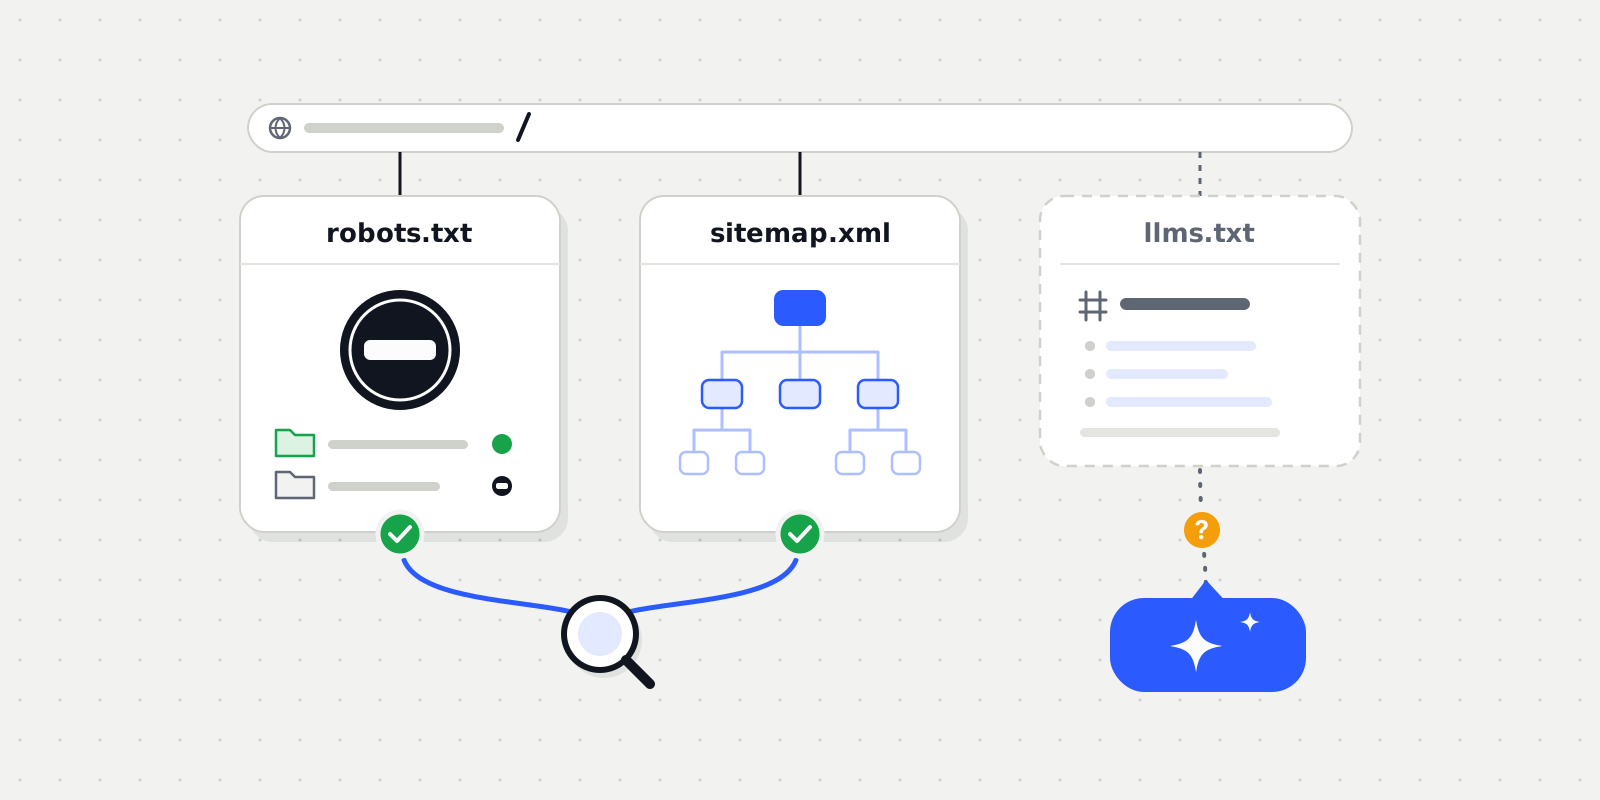
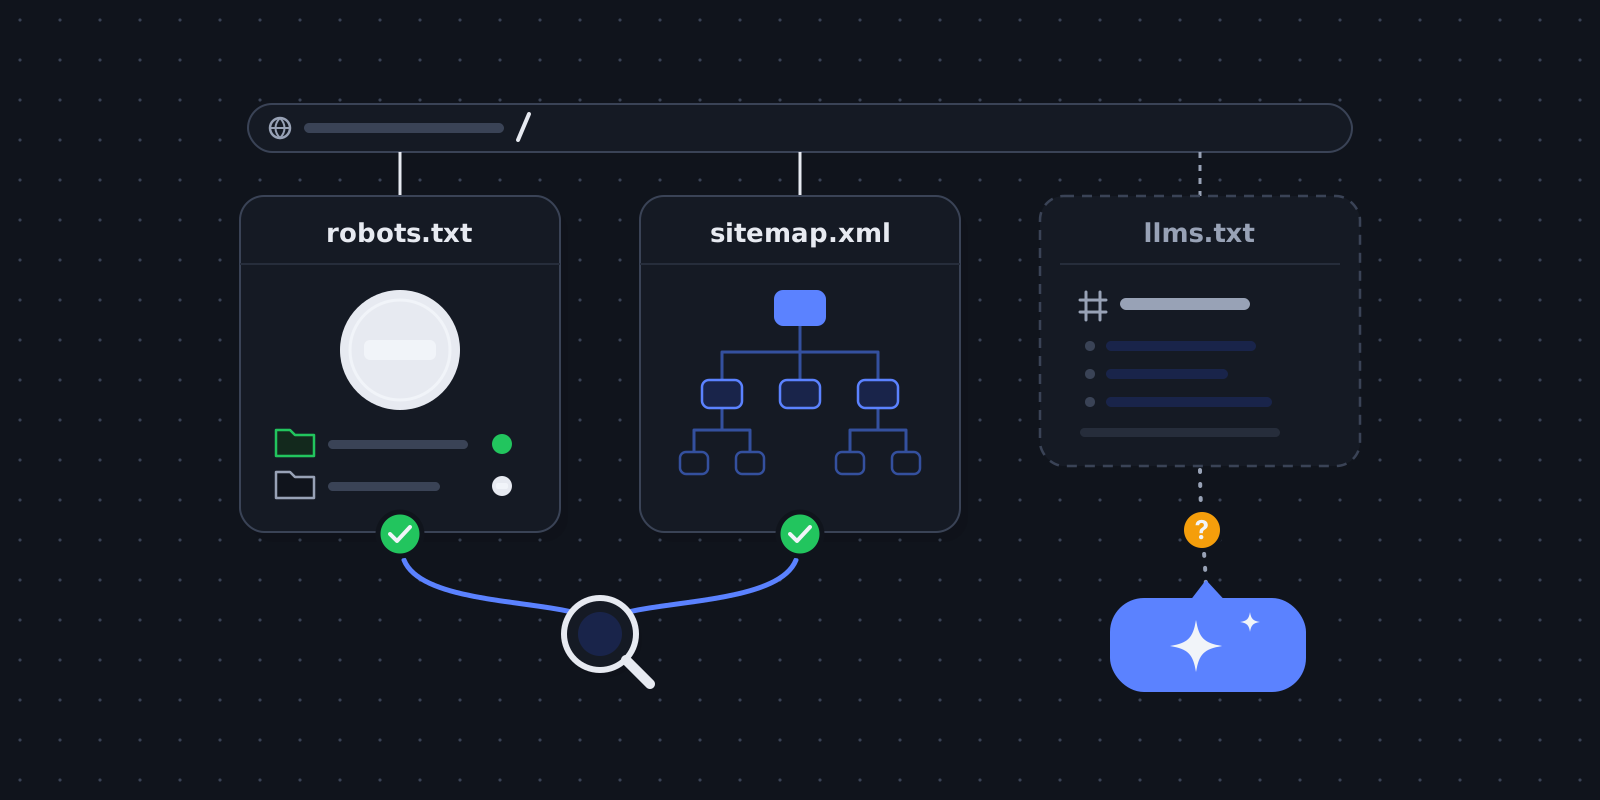
Le rôle de chaque robot dans les fichiers d'accès est détaillé dans notre guide robots.txt, sitemap.xml et llms.txt, et la lecture de leurs visites dans comment savoir si les IA lisent votre site.
Vérifier en cinq points si Cloudflare laisse passer les robots des IA
En bref
Cinq contrôles, dans cet ordre : savoir si le site passe par Cloudflare (en-tête Cf-Ray), lire les trois réglages dans le tableau de bord, lire le robots.txt réellement servi, chercher les visites des robots dans les journaux en vérifiant leurs adresses, puis tester la réponse du serveur robot par robot. Les deux premiers prennent cinq minutes.
- 1Le site passe-t-il par Cloudflare ? La documentation des en-têtes HTTP de Cloudflare, mise à jour le 15 novembre 2026, indique qu'il ajoute un en-tête Cf-Ray aux réponses. La page de Cloudflare décrit l'en-tête sans dire qu'il est toujours présent : si vous n'en voyez pas, demandez à votre hébergeur ou à votre agence si le site passe par Cloudflare.
- 2Les trois réglages. Dans le tableau de bord : Security > Settings, filtre Bot traffic, puis AI Crawler and Agent access policies. Notez les trois actions, et celle des agents personnels. AI Crawl Control montre quels services d'IA visitent le site.
- 3Le robots.txt servi. Ouvrez votresite.fr/robots.txt : l'action Disallow de Cloudflare passe par ce fichier, qui peut différer de celui de votre serveur.
- 4Les journaux. Cherchez OAI-SearchBot, Claude-SearchBot et PerplexityBot : un code 200 dit que la page a été servie, un 403 ou une page de défi qu'elle a été refusée. Recoupez l'adresse avec les listes publiées par OpenAI, Anthropic et Perplexity.
- 5Le test robot par robot. L'outil gratuit Robots IA demande votre page sous le nom de chaque robot et compare la réponse à celle d'un navigateur. Un refus y est un signal à vérifier dans le tableau de bord, pas une preuve.
curl -sI https://votresite.fr/ | grep -i cf-ray

# Une ligne cf-ray : le site passe par Cloudflare.Pourquoi un signal seulement : selon le billet de Cloudflare du 1er juillet 2026, les robots non vérifiés restent bloqués par défaut. Une requête au nom de PerplexityBot venue d'une autre adresse peut être refusée quand le vrai robot passe. Perplexity ajoute que le mode Bot Fight de Cloudflare ne se contourne pas par une règle de pare-feu personnalisée.
Exemple de lecture brute : le robots.txt d'evocia.fr, lu le 21 novembre 2026, contient « User-Agent: * » et 19 groupes nommés, dont OAI-SearchBot, GPTBot et ClaudeBot, tous en « Allow: / ». Evocia laisse aussi l'entraînement ouvert : c'est un choix, pas une règle.
Quel réglage Cloudflare garder pour rester cité sans livrer l'entraînement ?
En bref
Recherche autorisée, agents autorisés, et, si vous refusez l'entraînement, l'action Disallow plutôt que Block. Disallow passe par le robots.txt et, avec la synchronisation des préférences, bloque en bordure les robots d'entraînement sans toucher aux robots mixtes comme Googlebot et BingBot. Refuser l'entraînement reste un choix éditorial : aucune documentation ne le relie à vos citations.
| Comportement | Réglage minimal | Pourquoi | Limite |
|---|---|---|---|
| Recherche | Allow | Les robots de recherche alimentent les réponses qui citent des sources | Autoriser ne garantit ni passage ni citation |
| Agents | Allow, agents personnels compris (recommandation de Cloudflare) | Les agents ouvrent vos pages pendant une conversation | Sur un site avec publicité, vérifiez qu'aucun « Block on pages with ads » n'est actif |
| Entraînement | Disallow si vous refusez l'entraînement, Allow sinon ; jamais Block sans mesurer l'effet | Block s'applique aussi aux robots mixtes recherche et entraînement | Le robots.txt est volontaire, selon Cloudflare lui-même |
Recommandation d'Evocia du 21 novembre 2026, construite sur la page « Block AI bots » de Cloudflare (mise à jour du 2 novembre 2026). Elle ne dit rien de vos chances d'être cité.
- Google-Extended se refuse dans votre robots.txt (« User-agent: Google-Extended »). Google indique qu'il couvre aussi l'ancrage dans les applications Gemini : pesez-le si Gemini compte pour vous.
- Agents : le robots.txt peut ne pas s'appliquer à ChatGPT-User (OpenAI), et Perplexity-User l'ignore en général (Perplexity). Seul le réglage Agents de Cloudflare les arrête.
- Blocage par adresse IP : Anthropic le déconseille, car il empêche aussi ses robots de lire votre robots.txt.
Sur WordPress, le robots.txt peut venir d'un fichier physique ou d'une extension : l'ordre des réglages est expliqué dans notre guide GEO et AEO pour WordPress.
Pay per crawl : à qui il s'adresse
En bref
Pay per crawl fait payer les robots d'IA pour accéder à vos pages : le propriétaire fixe un prix par zone, le robot qui ne paie pas reçoit une réponse HTTP 402. Cloudflare le décrit, dans sa documentation de juillet et d'août 2026, comme une bêta fermée, sur inscription. Il vise les éditeurs dont les contenus intéressent les sociétés d'IA, pas les sites qui veulent être cités.
- Fonctionnement : Cloudflare agit comme vendeur officiel (merchant of record) ; une règle qui bloque un robot l'emporte sur la facturation. Accès sur inscription à la bêta.
- Ce que la documentation ne dit pas : quels éditeurs d'IA paient, et si un robot de recherche refusé faute de paiement continue de citer vos pages.
Notre avis : une PME, un éditeur SaaS ou un e-commerçant cherche à être lu et recommandé. Un péage devant les robots qui alimentent les réponses va à l'inverse, tant qu'aucun éditeur d'IA ne publie ce qu'il paie et cite en retour.
Ce que la vérification ne dit pas, et la suite
En bref
Un accès ouvert est une condition, pas un résultat. Cloudflare peut laisser passer OAI-SearchBot sans que ChatGPT cite jamais vos pages : la citation dépend de vos contenus, des sources tierces et de la question posée. La question suivante : votre entreprise est-elle nommée quand vos futurs clients interrogent les assistants ?
Les autres actions, contenus, sources et données structurées, sont rangés par niveau de preuve dans le hub Optimisation. Revérifiez à chaque changement d'hébergeur, d'agence ou d'offre Cloudflare : ces réglages ont déjà changé de nom et de défaut en 2026.
Robots autorisés, réglages relus : reste à savoir où votre site peut progresser, sur Google et dans les IA. Le diagnostic gratuit d'Evocia part de votre site et de vos concurrents, sans garantie de position ni de citation.
Découvrir mon potentielQuestions fréquentes
Qu'est-ce qu'AI Crawl Control de Cloudflare, et combien coûte-t-il ?
L'ancien AI Audit : la liste des services d'IA qui visitent votre site, des règles par robot et le suivi du respect du robots.txt. Sa documentation, mise à jour le 14 août 2026, le dit disponible sur toutes les formules ; Pay per crawl y est présenté comme une bêta.
Pay per crawl fonctionne-t-il avec WordPress ?
Il se règle au niveau de la zone Cloudflare, pas dans le CMS : la documentation ne cite ni WordPress ni extension. Un site WordPress derrière Cloudflare y a accès comme les autres, après admission à la bêta.
Faut-il autoriser OAI-SearchBot dans le robots.txt ?
Oui, si vous voulez apparaître dans les réponses de recherche de ChatGPT : selon OpenAI, un site qui l'exclut n'y figure plus, environ 24 heures après le changement. Vérifiez aussi que le réglage Recherche de Cloudflare ne le bloque pas en amont.
Sources
- Cloudflare, « Block AI bots » (mise à jour du 2 novembre 2026 : comportements Search, Agents, Training ; actions Block, Block on pages with ads, Allow, Disallow ; défaut des nouveaux domaines ; chemin du tableau de bord ; Bot Preference Sync ; robots mixtes), consulté le 21 novembre 2026
- Cloudflare, changelog « AI traffic options » du 1er juillet 2026 (défauts des nouveaux domaines à partir du 15 septembre 2026), consulté le 21 novembre 2026
- Cloudflare, billet « Your site, your rules » du 1er juillet 2026 (définitions, Googlebot, Applebot et BingBot robots mixtes, règle la plus restrictive, robots non vérifiés bloqués par défaut), consulté le 21 novembre 2026
- Cloudflare, billet « Content Independence Day » du 1er juillet 2025 (annonce du blocage par défaut, état antérieur aux réglages actuels), consulté le 21 novembre 2026
- Cloudflare, « AI Crawl Control » (mise à jour du 14 août 2026 : ancien AI Audit, toutes formules, Pay per crawl en bêta) et « What is Pay per crawl » (mise à jour du 28 juillet 2026 : prix par zone, HTTP 402, bêta fermée), consultés le 21 novembre 2026
- Cloudflare, « Cloudflare HTTP headers » (mise à jour du 15 novembre 2026 : en-tête Cf-Ray ajouté aux réponses), consulté le 21 novembre 2026
- OpenAI, « Overview of OpenAI crawlers » (OAI-SearchBot, GPTBot, ChatGPT-User, délai d'environ 24 heures, listes d'adresses), page sans date relue le 21 novembre 2026
- Anthropic, « Does Anthropic crawl data from the web, and how can site owners block the crawler? » (ClaudeBot, Claude-User, Claude-SearchBot, blocage par adresse IP déconseillé), mise à jour du 4 novembre 2026, relue le 21 novembre 2026
- Perplexity, guide des robots (PerplexityBot, Perplexity-User, listes d'adresses, délai de 24 heures, règles de pare-feu et mode Bot Fight de Cloudflare), mise à jour du 12 novembre 2026, relue le 21 novembre 2026
- Google, robots d'exploration courants (Google-Extended : jeton sans agent utilisateur propre, entraînement et ancrage Gemini, sans effet sur Google Search), page sans date relue le 21 novembre 2026
- Google Search Central, « AI features and your website » (page indexée et éligible à un extrait pour être un lien des aperçus IA et du mode IA), page sans date relue le 21 novembre 2026
Transparence et méthode
Auteur
Evocia · Équipe française de croissance SEO, GEO et AEO
Evocia mesure et améliore la visibilité des entreprises sur Google et dans les réponses des IA. Cet article s'appuie sur la documentation de Cloudflare, d'OpenAI, d'Anthropic, de Perplexity et de Google, relue à la date indiquée.
Comment cet article a été réalisé
- Article écrit le 21 novembre 2026 pour une question que le site ne traitait que dans une section du guide WordPress : ce que les réglages de Cloudflare font aux robots des IA. Requêtes de départ relevées le 15 novembre 2026 par l'autocomplétion de Google (cloudflare bloque chatgpt, ai crawl control cloudflare, pay per crawl cloudflare, oai searchbot robots txt) ; volume inconnu.
- Chaque réglage, défaut et rôle de robot vient d'une page officielle relue le 21 novembre 2026, avec sa date de mise à jour quand elle en a une. Ce que ces pages ne disent pas (défaut des domaines existants, catégorie Cloudflare de chaque robot, effet d'un blocage de Bingbot sur Copilot) est écrit comme non documenté ; la divergence entre deux pages de Cloudflare est signalée, pas tranchée.
- Aucun compte Cloudflare n'a été créé ni aucun réglage modifié. Le robots.txt et les en-têtes d'evocia.fr ont été lus en ligne de commande le 21 novembre 2026. Aucun chiffre de trafic ou de citation n'est repris, en particulier pas les ratios publiés par Cloudflare dans ses billets.
Historique des mises à jour
- 21 novembre 2026Publication initiale : réponse selon le réglage et la date du domaine, trois comportements de Cloudflare et piège des robots mixtes, tableau de onze robots (rôle, réglage concerné, effet d'un blocage), vérification en cinq points, réglage minimal, Pay per crawl, limites.